




A missão da Okta é permitir que todas as pessoas utilizem qualquer tecnologia de forma segura. A Okta lida com bilhões de autenticações por mês e ajuda os usuários a acessar seus aplicativos favoritos com segurança. Ela também bloqueia bilhões de solicitações maliciosas todos os meses, evitando ataques às identidades dos nossos clientes.
A plataforma da Okta possui uma estratégia de defesa em várias camadas para proteger as identidades. Um aspecto fundamental dessa estratégia de defesa em profundidade é o risco. A plataforma da Okta calcula o risco em vários níveis e é um componente crítico da nossa estratégia de defesa. Recomendamos fortemente que os clientes configurem políticas baseadas em risco para solicitar a MFA em logins de alto risco.
Atualmente, a pontuação de risco de identidade na Okta é impulsionada pelo que se espera de uma empresa de segurança madura: nossa pilha de aprendizado de máquina. Capturamos cada evento relevante relacionado à autenticação ou identidade, transformamos em um registro estruturado (IP, dispositivo, agente do usuário, país etc.), projetamos manualmente um grande conjunto de recursos e os inserimos em um modelo de aprendizado de máquina.
Isso alimenta a pontuação de risco de identidade em produtos como o Identity Threat Protection da IA da Okta, avaliando continuamente o risco do usuário e da sessão com base em sinais de rede, dispositivo e outros fatores.
No entanto, com o advento dos LLMs, começamos a experimentar novas abordagens e a questionar como poderíamos utilizá-los para a pontuação adaptativa de riscos. Afinal, os registros de segurança são fundamentalmente sequências de texto estruturado: tipos de eventos, endereços IP, agentes de usuário, IDs de organização, sinais geográficos e muito mais. Em vez de compactar tudo isso em um vetor de recursos fixo, seria possível tratar os registros como um fluxo de texto nativo e utilizar um LLM para realizar a pontuação de risco de identidade diretamente a partir dos dados de registro do sistema?
Este artigo descreve um desses experimentos: uma pontuação de risco adaptativa baseada em LLM que aprende padrões sequenciais e emite pontuações de anomalia usando um objetivo probabilístico.
Pontuação tradicional de aprendizado de máquina
Um fluxo de login não gera apenas um evento; ele gera uma linha do tempo de eventos relacionados. Para uma única identidade, uma fatia desse histórico pode ser semelhante a esta (simplificada):
t₁: event_type=user.session.start …
t₂: event_type=user.authentication.sso country=Germany
ip_address=145.224.xxx.xxx user_agent_raw=SFDC-Callout/64.0
browser=UNKNOWN os=Unknown device=Unknown as_org=amazon.com inc.
request_uri=/oauth2/.../v1/token …
t₃: event_type=inline_hook.response.processed …
t₄: event_type=user.authentication.sso …
t₅: event_type=user.session.end …
Com o tempo, o histórico do usuário se torna uma sequência:
[e1, e2, …, e(n−1), en]
No pipeline tradicional, esses eventos brutos quase nunca são alimentados diretamente em um modelo. Em vez disso, condensamos a sequência em recursos projetados calculados em janelas de tempo ou histórico. Por exemplo:
- “Este IP é novo para este usuário?”
- “Este ASN é novo para esta organização?”
- “Já observamos agentes de usuário semelhantes no passado?”
- …e muito mais
O evento recebido torna-se um vetor de recursos numéricos em relação ao histórico anterior do usuário, por exemplo:
features(event) → x ∈ ℝᵈ
Um modelo aprende um mapeamento:
risk = f(x)
em que f normalmente é um modelo de aprendizado de máquina.
A questão é que o histórico de eventos para essa identidade é compactado em um punhado de contadores e sinalizadores (ou seja, recursos). O modelo na verdade não "vê" a história da identidade ao longo do tempo; ele vê um instantâneo e alguns números agregados. O aspecto sequencial também se perde nessa compactação.
Por que usar um LLM?
Os LLMs se destacam exatamente naquilo que os registros de segurança representam: sequências de texto semiestruturado. Em vez de analisar um login isoladamente, um LLM é capaz de consumir uma linha do tempo com todos os eventos importantes de um usuário ou agente:
“Essa identidade geralmente é autenticada na Alemanha, por meio de um cliente de API, durante o horário comercial, com uma string de agente de usuário muito específica…”
A partir disso, o modelo pode aprender implicitamente:
- O que é considerado “normal” para cada identidade
- Quais combinações de campos tendem a ocorrer em conjunto
- Quando um novo evento se afasta dessa referência de maneira sutil
- Se um novo evento é, de fato, uma anomalia em nível global
Há três grandes vantagens:
- Sequências
Os LLMs conseguem ler múltiplos eventos em sequência, não apenas um único instantâneo. Eles tratam toda a sequência como uma história e avaliam se o próximo capítulo faz sentido. - Menos engenharia manual de recursos
Em vez de projetar centenas de recursos manualmente, deixamos o modelo aprender padrões diretamente do texto bruto dos eventos. Isso economiza tempo de engenharia.
- Melhor generalização para novos padrões
Como analisa sequências completas, o modelo pode sinalizar combinações surpreendentes que nunca viu para aquela identidade, mesmo que não tenhamos criado um recurso para aquele padrão específico.
Isso significa que, em vez de consolidar tudo em um único instantâneo, podemos fornecer toda a sequência de eventos de um usuário ou agente a um modelo LLM ajustado e perguntar: considerando a maneira como essa identidade geralmente se comporta, este próximo evento parece normal ou estranho?
De modo geral, existem duas partes principais no sistema:
- Ensinar um LLM a prever o próximo evento considerando o perfil histórico do usuário e os eventos e tokens precedentes.
- Utilizar a surpresa do modelo como uma pontuação de risco/anomalia
Vamos falar sobre isso a seguir.
Ajuste fino do LLM
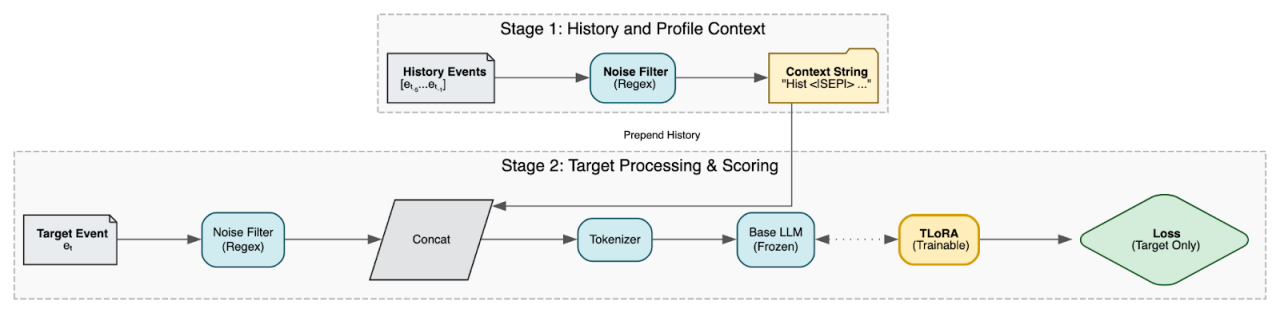
O ajuste fino de um LLM é, essencialmente, uma forma de ensinar os padrões observados diariamente nos dados de identidade da Okta. A configuração experimental que estamos usando consiste em três estágios: construir um contexto histórico ou perfil para o usuário, condicionar o LLM nesse perfil e treiná-lo para prever o próximo evento.
1. Transformar o histórico de eventos em um perfil
Para uma determinada identidade, começamos com uma sequência de eventos passados:
history = [e₁, e₂, …, eₙ₋₁],
current event to score = eₙ.
Em vez de converter tudo isso em vetores abstratos, optamos por tratar a sequência de texto bruto como o perfil. No entanto, os registros brutos contêm ruído de alta entropia (IDs de transação aleatórios, hashes, nonces) que confundem o modelo. Passamos cada evento por um filtro de ruído que substitui esses valores aleatórios por marcadores estáticos (por exemplo, <ID>).
Essas sequências de texto limpas são usadas para criar um perfil p. Isso captura "a forma como essa identidade normalmente se apresenta" ao longo de seu histórico recente (países, ASNs, agentes de usuário e padrões de fluxo) em um formato que o LLM pode ler nativamente.
2. Condicionar um modelo de linguagem ao perfil
Em seguida, utilizamos um modelo de linguagem no estilo GPT e modificamos a entrada para que ele não apenas visualize o evento eₙ, mas também o contexto histórico p.
Isso é feito por meio de prompts contextuais. Concatenamos os eventos históricos (perfil) com o evento de destino, separando-os com um token especial. Em vez de o modelo ver apenas o alvo:
[tokens(eₙ)]
Ele vê a narrativa comportamental completa:
[tokens(e₁), , tokens(e₂), ... , tokens(eₙ)]
Isso força o modelo a codificar "aqui está o comportamento sequencial desta identidade; preveja os tokens a seguir nesse contexto".
Para garantir a eficiência, não treinamos todo o modelo de linguagem novamente. Congelamos o modelo base e anexamos pequenas camadas de adaptador de ordem baixa e usamos um método de ajuste fino desenvolvido internamente chamado TLoRA. Somente os adaptadores são treinados, o que mantém a pegada reduzida.
3. Objetivo do treinamento
Os dados de treinamento provêm de sequências de históricos de eventos reais. Para cada sequência:
- Alimentamos a sequência completa Perfil + Alvo no modelo.
- Calculamos a perda exclusivamente no evento-alvo eₙ.
Treinamos o modelo usando um objetivo de modelagem de linguagem padrão (Previsão do Próximo Token): ele atribui alta probabilidade a cada token no último evento, dado o histórico específico do usuário. O modelo é recompensado quando antecipa corretamente a próxima ação do usuário com base em seu comportamento anterior e é penalizado quando é surpreendido.
Ao longo de várias identidades e sequências, o modelo aprende uma noção de "próximo evento normal" condicionado ao perfil específico do usuário p.
Pontuação de risco baseada na perplexidade
Depois que o modelo é treinado, podemos transformar sua “surpresa” em uma pontuação de anomalia.
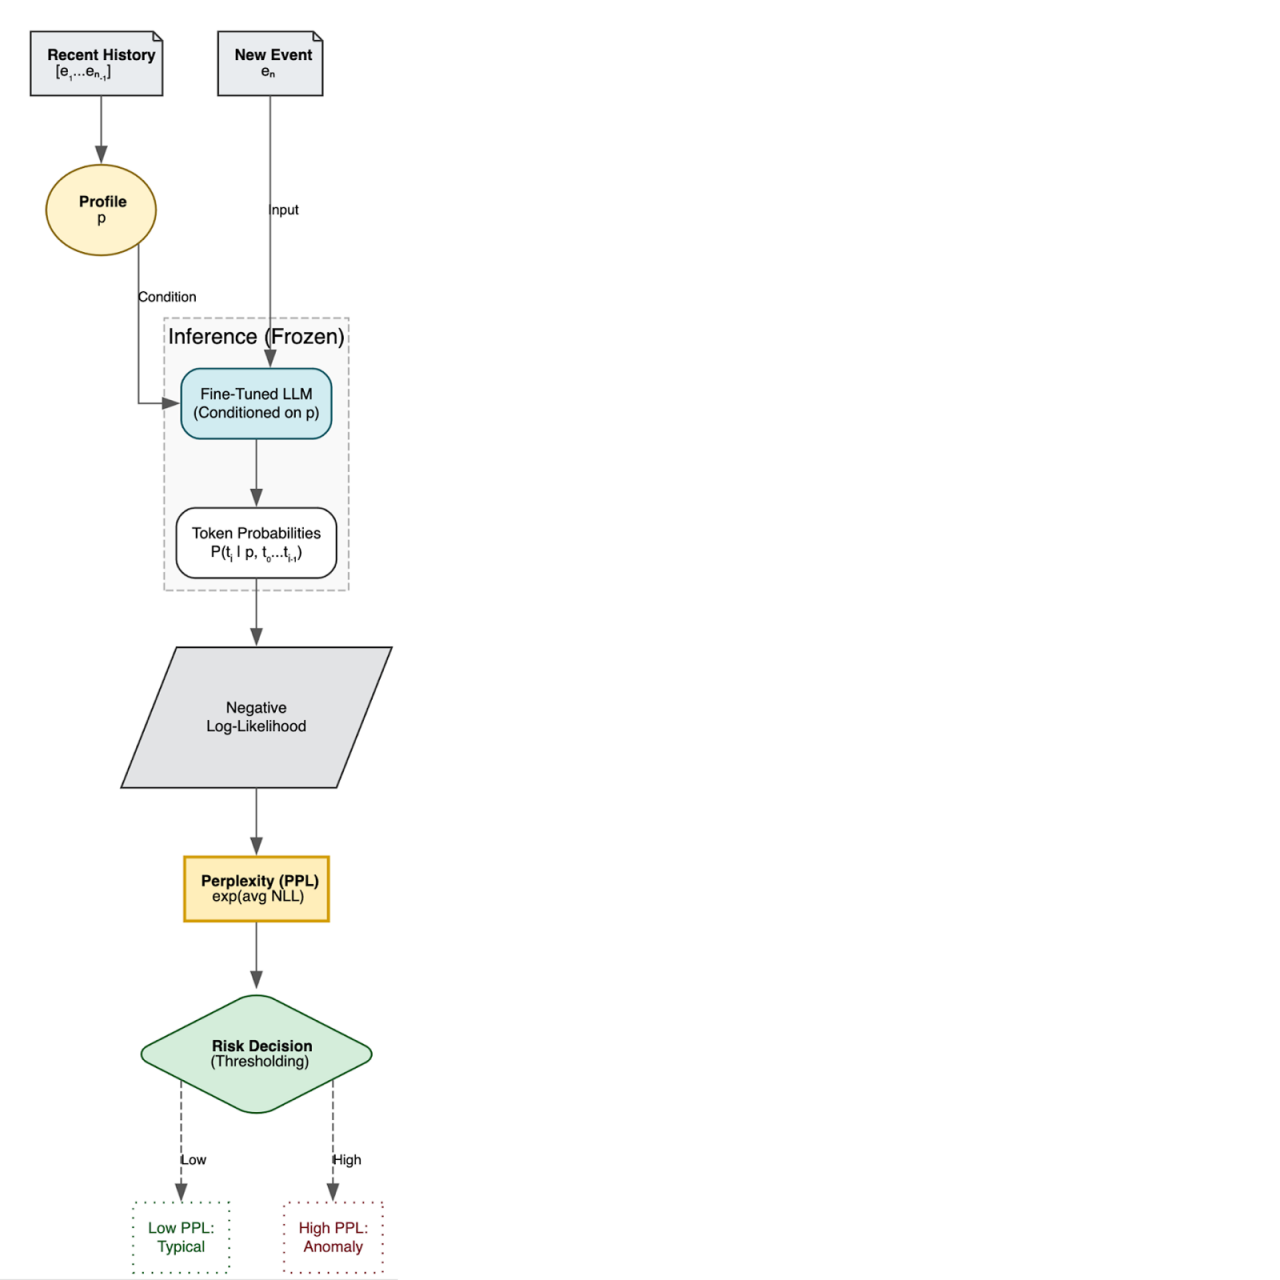
Resumindo, para um novo evento recebido:
- Recupere o perfil p do histórico recente da identidade.
- Insira o perfil e o evento tokenizado no modelo.
- Pergunte: qual é a probabilidade de cada token desse evento, considerando o perfil e os tokens precedentes?
Isso nos dá uma verossimilhança logarítmica negativa (NLL) por token e perplexidade:
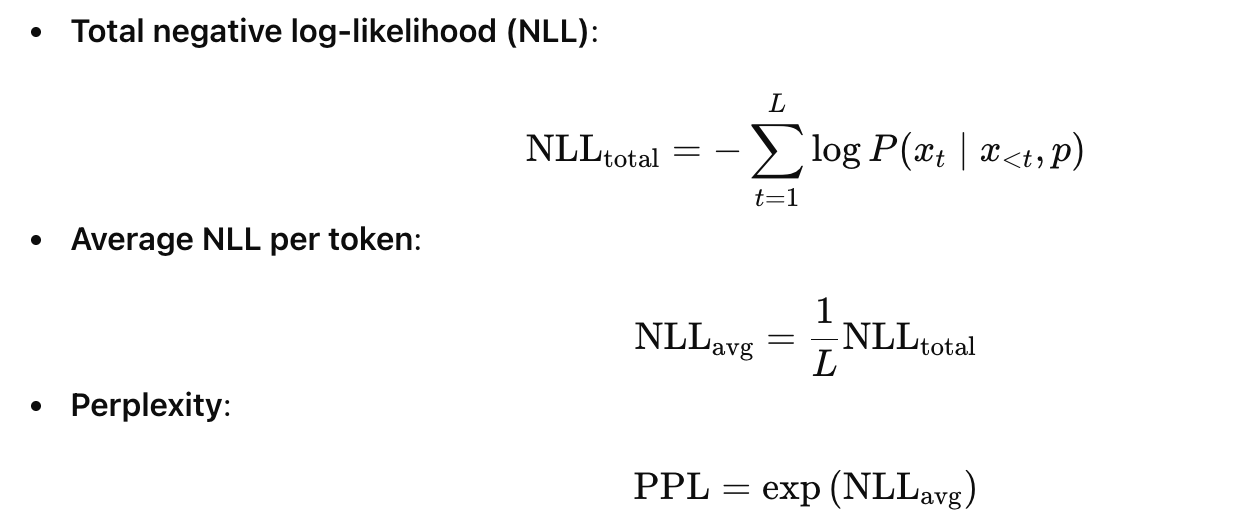
No entanto, as linhas de registro padrão contêm uma quantidade significativa de texto padronizado e repetitivo que dilui o sinal. Portanto, em vez de uma média global simples, calculamos a perplexidade de pico. Isolamos os tokens Top-K mais surpreendentes (ou seja, os valores NLL mais altos) no evento de destino, calculamos a média apenas desses e, em seguida, aplicamos a exponenciação. Isso garante que a pontuação se concentre nas informações (por exemplo, país, ISP, dispositivo) em vez da estrutura.
Operacionalmente, a pontuação de risco é derivada desta perplexidade:
- PPL baixo → Risco baixo: o evento parece muito típico para essa identidade.
- PPL alto → Risco alto: o evento parece incomum, considerando tudo o que o modelo aprendeu e inferiu com base no histórico dessa identidade.
Como o modelo é condicionado pelo perfil de identidade, ele é considerado inerentemente adaptativo.
Exemplo conceitual
Para ilustrar como isso funciona na prática, vamos analisar uma sequência real processada pelo nosso modelo.
O modelo lê o histórico de eventos como uma narrativa. Ele estabelece um "perfil" para o usuário com base no contexto: onde ele está, qual dispositivo ele usa e como normalmente se autentica. Em seguida, avalia o Evento alvo para verificar se ele se encaixa nessa narrativa.
Abaixo está um rastreamento simplificado de uma sessão de usuário. Removemos o ruído de alta entropia (como IDs e hashes) para mostrar exatamente em que o modelo se concentra. Esta é uma versão simplificada.
1. O contexto (perfil)
O modelo consome esses eventos primeiro para entender o estado atual do usuário.
[T-3] Início da sessão xevent_type=user.session.start | country=United
[T-2] Verificação MFA event_type=user.authentication.verify |
country=United States | os=Windows 10 | device=Computer |
result=SUCCESS
[T-1] Autenticação interna event_type=security.internal.authentication |
country=United States | os=Windows 10 | device=Computer
2. A anomalia (evento alvo)
O usuário acessa o app administrador de repente, mas o contexto mudou drasticamente.
[T-0] Acesso de administrador event_type=user.session.access_admin_app |
country=India | city=Chennai | os=Android | device=Mobile
Como a pontuação é calculada
Quando o modelo processa o evento alvo, ele calcula a probabilidade de cada token, dado o perfil.
Com base no contexto estabelecido de "Estados Unidos" e "Windows", o modelo prevê fortemente que esses tokens aparecerão outra vez. Quando encontra Índia e Android, a probabilidade para essas palavras específicas cai para perto de zero. Essa incompatibilidade contextual causa um aumento significativo na perda dos tokens, elevando a pontuação de perplexidade de pico o suficiente para sinalizar a anomalia.
Usando a perplexidade de pico, o LLM isola a contradição semântica: o usuário não pode viajar fisicamente do Kansas para Chennai de forma instantânea e trocar de dispositivo durante o processo.
Olhando para o futuro
Essa pontuação de risco de identidade baseada em LLM ainda está na fase experimental, mas indica um caminho concreto e de base matemática para o futuro:
- Nós passamos de vetores de recursos projetados manualmente para modelos de sequência condicionados por perfil.
- Obtemos uma pontuação de anomalia fundamentada utilizando NLL e perplexidade em vez de pesos de regra ad hoc.
- Podemos integrar essa pontuação de anomalia nos fluxos de trabalho de risco existentes como um sinal adicional, em vez de substituir o que está funcionando atualmente.
O trabalho futuro se concentrará em aprimorar a construção de perfis, calibrar o mapeamento de perplexidade para risco e possíveis extensões, como gerar explicações em linguagem natural para justificar por que um evento foi considerado surpreendente.


