




La misión de Okta es permitir que todas las personas usen cualquier tecnología de manera segura. Okta gestiona miles de millones de autenticaciones por mes y ayuda a los usuarios a acceder de forma segura a sus aplicaciones favoritas. Okta también bloquea miles de millones de solicitudes maliciosas por mes y protege las identidades de los clientes ante los ataques.
La plataforma de Okta cuenta con una estrategia de defensa multicapa para proteger las identidades. Un aspecto clave de esa profunda estrategia de defensa es el riesgo. La plataforma de Okta calcula el riesgo en varios niveles y es un componente esencial de nuestra estrategia de defensa. Les recomendamos a los clientes que configuren políticas basadas en riesgos para solicitar la MFA en inicios de sesión de alto riesgo.
Actualmente, la evaluación de riesgos de identidad en Okta está impulsada por lo que cabría esperar de una empresa de seguridad consolidada: nuestra pila de ML. Tomamos cada evento relevante relacionado con la autenticación o la identidad, lo convertimos en un registro estructurado (IP, dispositivo, agente de usuario, país, etc.), diseñamos manualmente un amplio conjunto de características y alimentamos con ellas un modelo de aprendizaje automático.
Esto, a su vez, posibilita puntuar el riesgo de identidad en productos como Identity Threat Protection de Okta AI y evaluar de forma continua el riesgo de los usuarios y las sesiones mediante señales de red, de dispositivos y de otro tipo.
Sin embargo, con la llegada de los LLM, empezamos a experimentar con nuevos enfoques y a preguntarnos cómo podemos aprovecharlos para la evaluación de riesgos adaptativa. Después de todo, los registros de seguridad son, en esencia, secuencias de texto estructurado: tipos de eventos, direcciones IP, agentes de usuario, ID de organizaciones, señales geográficas y más. En lugar de comprimir todo esto en un vector de características fijo, ¿podemos tratar los registros como un flujo de texto nativo y usar un LLM para realizar la puntuación del riesgo de identidad directamente a partir de los datos del registro de sistema?
En esta publicación, se describe uno de estos experimentos: una evaluación adaptativa de riesgos basada en un LLM que aprende los patrones secuenciales y emite puntuaciones de anomalías mediante un objetivo probabilístico.
Puntuación de ML tradicional
Un flujo de inicio de sesión no produce solo un evento, sino que genera una secuencia de eventos relacionados. Para una sola identidad, un fragmento de esa historia podría verse así (esta es una versión simplificada):
t₁: event_type=user.session.start …
t₂: event_type=user.authentication.sso country=Germany
ip_address=145.224.xxx.xxx user_agent_raw=SFDC-Callout/64.0
browser=UNKNOWN os=Unknown device=Unknown as_org=amazon.com inc.
request_uri=/oauth2/.../v1/token …
t₃: event_type=inline_hook.response.processed …
t₄: event_type=user.authentication.sso …
t₅: event_type=user.session.end …
Con el tiempo, el historial del usuario se convierte en una secuencia:
[e1, e2, …, e(n−1), en]
En el pipeline tradicional, casi nunca ingresamos estos eventos sin procesar directamente en un modelo. En cambio, reducimos la secuencia a características diseñadas y calculadas en períodos de tiempo o históricos, por ejemplo:
- “¿Es esta dirección IP nueva para este usuario?”
- “¿Es este ASN nuevo para esta organización?”
- “¿Vimos agentes de usuario similares en el pasado?”
- … etc.
El evento entrante se convierte en un vector de característica numérico relacionado con el historial pasado del usuario, por ejemplo:
features(event) → x ∈ ℝᵈ
Un modelo aprende una asignación:
risk = f(x)
donde f suele ser un modelo de aprendizaje automático.
El inconveniente es que el historial de eventos para esa identidad se comprime en un puñado de contadores y marcadores (también llamados características). El modelo realmente no “ve” la historia de la identidad a lo largo del tiempo; ve una instantánea y algunos números combinados. El aspecto secuencial también se pierde en esa compresión.
¿Por qué los LLM?
Los LLM se destacan precisamente en lo que los registros de seguridad representan: secuencias de texto semiestructurado. En lugar de analizar un inicio de sesión de forma aislada, un LLM puede procesar una cronología de todos los eventos importantes de un usuario o agente:
“Normalmente, esta identidad se autentica desde Alemania, mediante un cliente API, durante el horario laboral, con una cadena de agente de usuario muy específica…”
A partir de esto, el modelo puede aprender implícitamente:
- Qué es “lo normal” para cada identidad
- Qué combinaciones de campos tienden a coincidir
- Cuándo un evento nuevo se desvía sutilmente de esa referencia
- Si un evento nuevo constituye una anomalía a nivel global
Hay tres grandes ventajas:
- Secuencias
Los LLM pueden leer varios eventos en secuencia, no solo una instantánea. Consideran toda la secuencia como una historia y juzgan si el siguiente capítulo tiene sentido. - Menos diseño manual de características
En lugar de diseñar cientos de características manualmente, permitimos que el modelo aprenda patrones directamente del texto sin procesar de los eventos. Esto ahorra tiempo de ingeniería.
- Mejor generalización para patrones nuevos
Debido a que el modelo analiza secuencias completas, puede identificar combinaciones sorprendentes nunca antes detectadas para esa identidad, incluso si no desarrollamos una característica para ese patrón específico.
Esto significa que, en lugar de reducir todo a una sola instantánea, podemos suministrar a un LLM ajustado la secuencia completa de eventos de un usuario o agente y preguntar: Dado el comportamiento habitual de esta identidad, ¿este próximo evento parece normal o es inusual?
A un nivel general, hay dos partes clave en el sistema:
- Enseñar a un LLM a predecir el siguiente evento considerando el perfil histórico del usuario y los eventos y tokens anteriores.
- Usar la sorpresa del modelo como una puntuación de anomalía o riesgo.
De eso hablaremos a continuación.
Ajuste del LLM
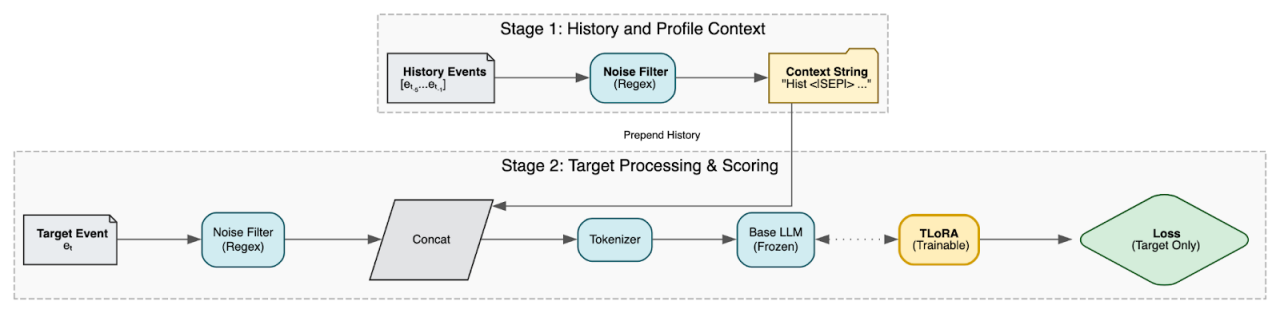
Ajustar un LLM implica, en esencia, enseñarle los patrones que observamos diariamente en los datos de identidad de Okta. La configuración experimental que usamos actualmente consta de tres etapas: crear un contexto histórico o perfil para el usuario, adaptar el LLM a ese perfil y entrenarlo para predecir el próximo evento.
1. Convertir el historial de eventos en un perfil
Para una identidad específica, comenzamos con una secuencia de eventos pasados:
history = [e₁, e₂, …, eₙ₋₁],
current event to score = eₙ.
En lugar de convertirlos en vectores abstractos, tratamos la secuencia de texto sin procesar como el perfil. Sin embargo, los registros sin procesar contienen ruido de alta entropía (ID de transacción aleatorios, hashes, valores de un solo uso) que confunden al modelo. Pasamos cada evento a través de un filtro de ruido que reemplaza estos valores aleatorios con marcadores de posición estáticos (p. ej., <ID>).
Estas secuencias de texto limpias se utilizan para crear un perfil al que llamaremos “p”. Este perfil capta “cómo se ve normalmente la identidad” a lo largo de su historia reciente: países, ASN, agentes de usuario y patrones de flujo, en un formato que el LLM puede leer de forma nativa.
2. Condicionar un modelo de lenguaje en el perfil
Luego, tomamos un modelo de lenguaje estilo GPT y modificamos la entrada para que no solo vea el evento eₙ, sino también el contexto histórico de p.
Para hacerlo, usamos indicaciones contextuales. Concatenamos los eventos históricos (perfil) con el evento objetivo y los separamos con un token especial. Así que, en lugar de que el modelo solo vea el objetivo:
[tokens(eₙ)]
Ve la narrativa de comportamiento completa:
[tokens(e₁), , tokens(e₂), ... , tokens(eₙ)]
Esto obliga al modelo a codificar lo siguiente: “este es el comportamiento secuencial de esta identidad; hay que predecir los próximos tokens en ese contexto”.
Para que esto sea eficiente, no volvemos a entrenar todo el modelo de lenguaje. Dejamos el modelo básico y agregamos pequeñas capas de adaptadores de bajo rango. Utilizamos un método de ajuste desarrollado internamente llamado TLoRA. Solo se entrenan los adaptadores, lo que mantiene un tamaño pequeño.
3. Objetivo de la capacitación
Los datos de capacitación provienen de secuencias de historiales de eventos reales. Para cada secuencia:
- Suministramos la secuencia completa de Profile + Target al modelo.
- Calculamos la pérdida exclusivamente en el evento objetivo eₙ.
Entrenamos el modelo utilizando un objetivo estándar de modelado de lenguaje (predicción del próximo token), que asigna una alta probabilidad a cada token en el último evento, dado el historial específico del usuario. El modelo es recompensado cuando anticipa correctamente la siguiente acción del usuario basándose en su comportamiento pasado, mientras que es penalizado cuando se sorprende.
A través de muchas identidades y secuencias, el modelo desarrolla una noción de “próximo evento habitual” condicionado al perfil p específico del usuario.
Puntuación de riesgo basada en perplejidad
Una vez que el modelo está entrenado, podemos convertir su “sorpresa” en una puntuación de anomalía.
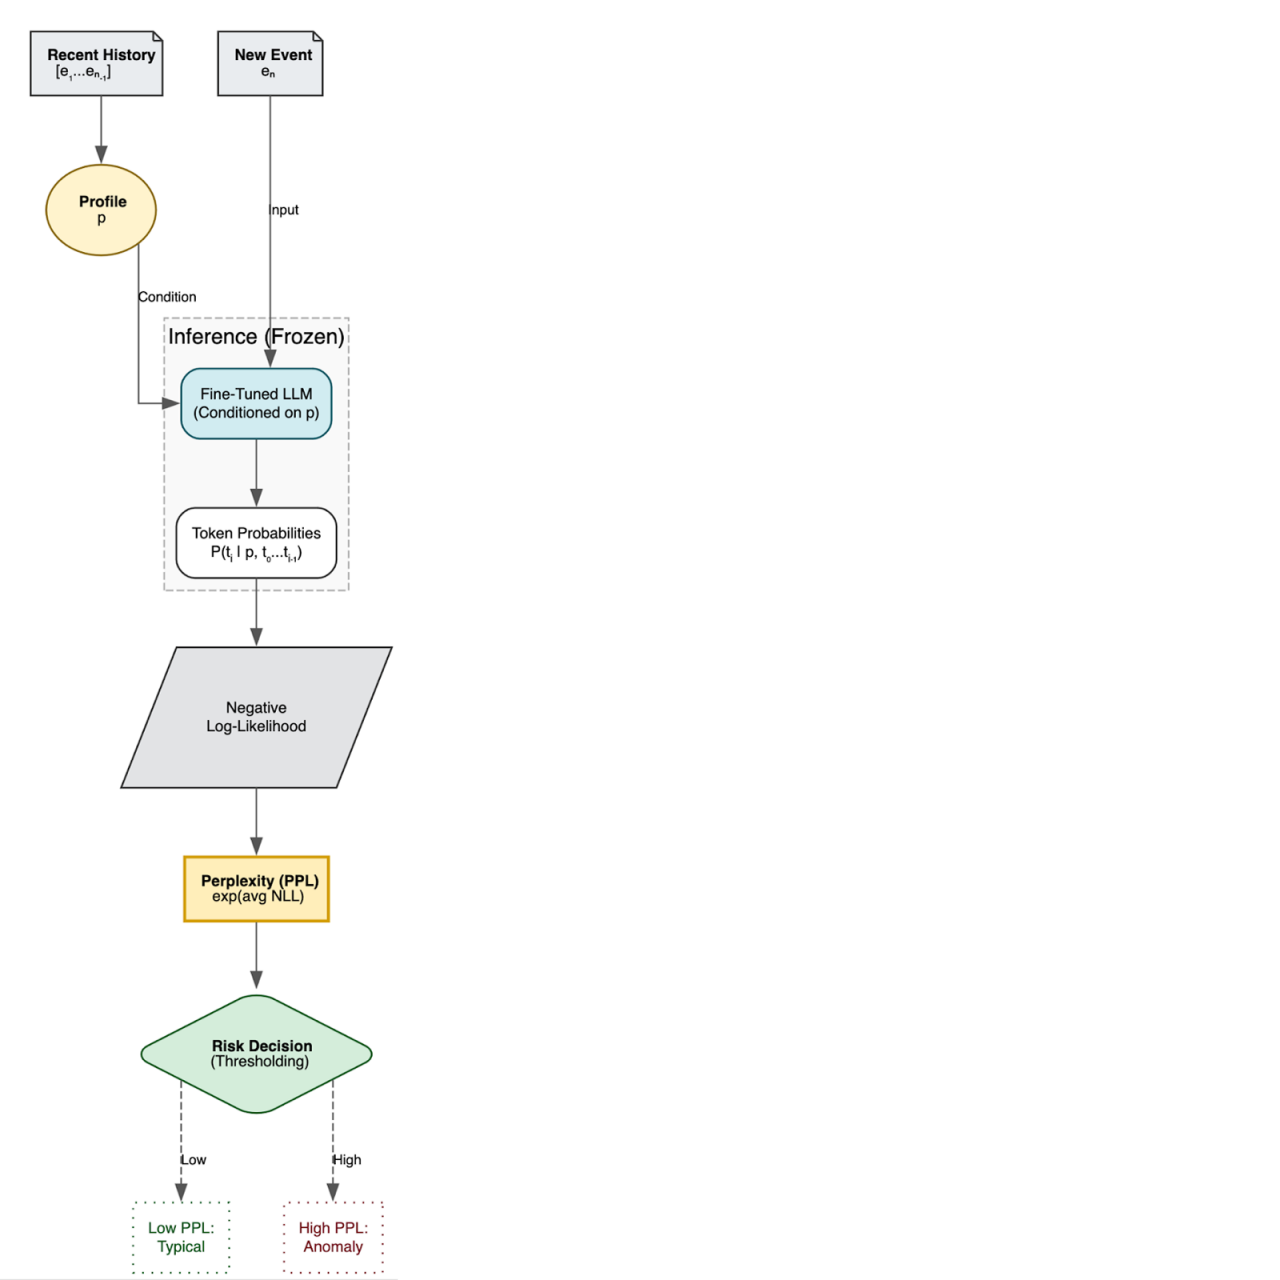
En resumen, para un nuevo evento entrante:
- Recupere el perfil p del historial reciente de la identidad.
- Suministre el perfil y el evento con token al modelo.
- Pregunte: “¿Qué tan probable era cada token de este evento, en función del perfil y los tokens anteriores?”.
Esto nos proporciona una pérdida de máxima verosimilitud negativa (NLL) por token y perplejidad:
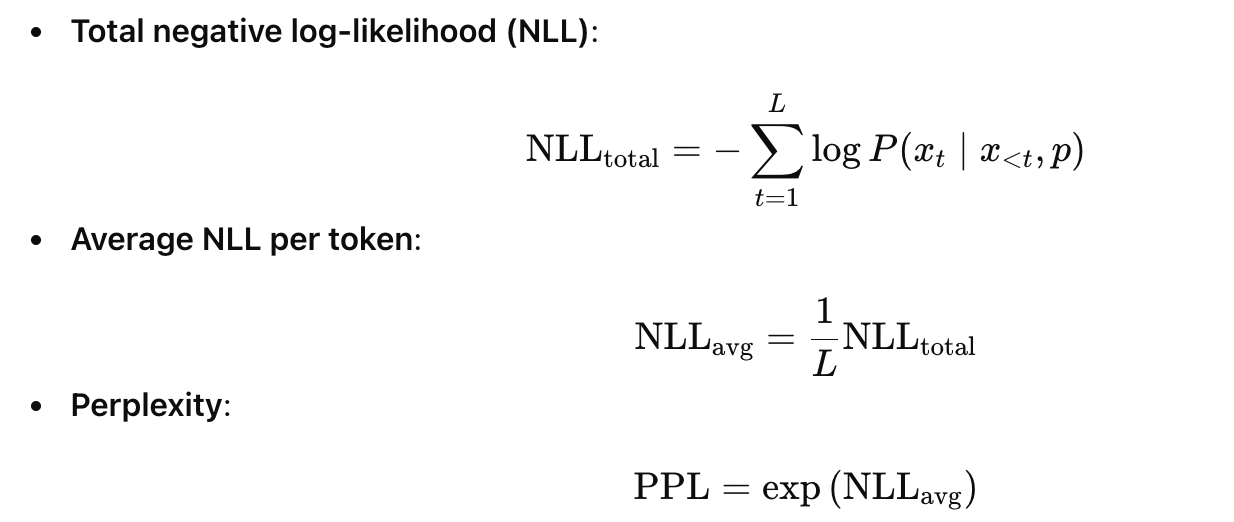
Sin embargo, las líneas de registro estándar contienen una cantidad significativa de texto estático y redundante que diluye la señal. Por lo tanto, en lugar de un promedio global simple, calculamos la perplejidad máxima. Aislamos los tokens más sorprendentes (es decir, los valores NLL más altos) en el evento objetivo, promediamos solo esos y luego hacemos el cálculo exponencial. Esto garantiza que la puntuación se enfoque en la información (p. ej., país, ISP o dispositivo) en lugar de la estructura.
Operacionalmente, la puntuación de riesgo deriva de esta perplejidad:
- Perplejidad baja → Riesgo bajo: este evento parece muy propio de esta identidad.
- Perplejidad alta → Riesgo alto: el evento se ve inusual, dado todo lo que el modelo ha aprendido e inferido basándose en el historial de esta identidad.
Como el modelo está condicionado al perfil de cada identidad, es adaptativo por naturaleza.
Ejemplo conceptual
Para ilustrar cómo funciona esto en la práctica, veamos una secuencia real procesada por nuestro modelo.
El modelo lee el historial de eventos como una narrativa. Establece un “perfil” del usuario basado en su contexto: dónde se encuentra, qué dispositivo utiliza y cómo se autentica normalmente. Luego, evalúa el evento objetivo para ver si se ajusta a esa narrativa.
A continuación, se muestra el seguimiento simplificado de una sesión de usuario. Quitamos el ruido de alta entropía (como ID y hashes) para mostrar exactamente en qué se enfoca el modelo. Se trata de una versión simplificada.
1. El contexto (perfil)
El modelo consume estos eventos primero para entender el estado actual del usuario.
[T-3] Inicio de sesión xevent_type=user.session.start | country=United
[T-2] Verificación con MFA event_type=user.authentication.verify |
country=United States | os=Windows 10 | device=Computer |
result=SUCCESS
[T-1] Autenticación interna event_type=security.internal.authentication |
country=United States | os=Windows 10 | device=Computer
2. La anomalía (evento objetivo)
El usuario accede repentinamente a la aplicación de administrador, pero el contexto ha cambiado drásticamente.
[T-0] Acceso de administrador event_type=user.session.access_admin_app |
country=India | city=Chennai | os=Android | device=Mobile
Cómo se calcula la puntuación
Cuando el modelo procesa el evento objetivo, calcula la probabilidad de cada token en función del perfil.
Basado en el contexto establecido de “United States” (Estados Unidos) y “Windows”, el modelo predice con firmeza que esos tokens aparecerán de nuevo. Cuando aparecen India y Android, la probabilidad de esas palabras específicas se reduce a casi cero. Esta discrepancia contextual provoca un aumento significativo en la pérdida de esos tokens y eleva la puntuación de perplejidad máxima lo suficiente como para identificar la anomalía.
Al usar la perplejidad máxima, el LLM aísla la contradicción semántica: el usuario no puede trasladarse físicamente de Kansas a Chennai de inmediato ni cambiar de dispositivo en medio del proceso.
El futuro
Esta puntuación de riesgo de identidad basada en LLM aún se encuentra en fase experimental, pero nos proporciona un camino concreto, fundamentado matemáticamente, para avanzar:
- Pasamos de vectores de características diseñados manualmente a modelos de secuencia condicionados por los perfiles.
- Obtenemos una puntuación de anomalía basada en principios mediante NLL y perplejidad, en lugar de valores de reglas ad hoc.
- Podemos integrar esta puntuación de anomalía en los pipelines de riesgo actuales como una señal adicional, en lugar de sustituir lo que funciona actualmente.
De cara al futuro, deberíamos mejorar la creación de perfiles; calibrar la asignación de perplejidad al riesgo; y desarrollar posibles extensiones, como la generación de explicaciones en lenguaje natural de por qué un evento se consideró sorprendente.


