



En ce moment, presque tous les RSSI et DSI voient cette question arriver dans leur boîte de réception :
« Ces histoires d’agents d’IA ont l’air géniales. Mais combien d’administrateurs d’identité vais-je devoir embaucher pour gérer tout ça ? »
C’est une question tout à fait légitime. Mais ce n’est pas la bonne question à se poser, car les entreprises qui considèrent la gouvernance des agents d’IA comme un problème de personnel échoueront inévitablement. Non pas parce qu’elles n’arrivent pas à embaucher assez rapidement (même si elles le pouvaient), mais parce qu’aucune quantité d’administration humaine ne résout un problème qui est, fondamentalement, de nature architecturale.
La question n’est pas de savoir combien de personnes vous devez employer pour gérer les agents d’IA, mais quelles bases vous devez poser afin que la réponse reste gérable à mesure que votre flotte d’agents passe de quelques dizaines à plusieurs milliers, voire plus encore. Ces bases commencent par l’identité, et vous devez les poser maintenant.
Pourquoi le problème d’identité des agents d’IA est différent de tous les problèmes d’IAM que vous avez résolus auparavant
Les agents d’IA enfreignent toutes les hypothèses et règles sur lesquelles la gestion des identités et des accès (IAM) traditionnelle repose. Parmi les règles traditionnelles :
- L’identité s’adapte à nos effectifs ou à l’acquisition de clients. L’IAM des humains s’est développé à mesure que vous embauchiez des collaborateurs ou acquériez des clients. L’IAM des agents s’adapte aux pipelines de déploiement. Un seul développeur peut déployer des centaines d’agents avant l’heure du déjeuner. Vos processus de provisioning n’ont pas été conçus pour cette vélocité, et une équipe d’administrateurs d’identité travaillant à partir d’une file d’attente de tickets non plus.
- Les identités sont connues avant d’être nécessaires. Le provisioning traditionnel suppose qu’une personne soumet une requête, qu’une identité est créée et que l’accès est accordé. Avec les agents, le déploiement peut déjà être en production avant même que votre équipe sécurité ne soit au courant de son existence. Vous ne pouvez pas compenser un manque de visibilité initiale par une augmentation des effectifs.
- Les mandants se comportent de manière prévisible. Un compte de service appelle les trois mêmes API dans le même ordre à chaque fois. Un agent prend des décisions autonomes concernant ce à quoi il accède en fonction de son contexte et de ses instructions. La surface d’attaque ne se limite plus aux identifiants qu’il détient, mais englobe également les décisions qu’il prend.
- Les chaînes d’identité sont superficielles. L’IAM a été conçu pour un modèle d’utilisateur à application ou d’utilisateur à système — tout en simplicité. Les agents introduisent des modèles entièrement nouveaux, tels que des modèles d’agent à agent, d’agent à outil ou d’agent à agent à application, ce qui crée des réseaux d’accès complexes. Le problème, c’est qu’un administrateur examinant un ticket de provisioning n’a aucun moyen d’évaluer le risque d’une chaîne qu’il ne peut pas voir.
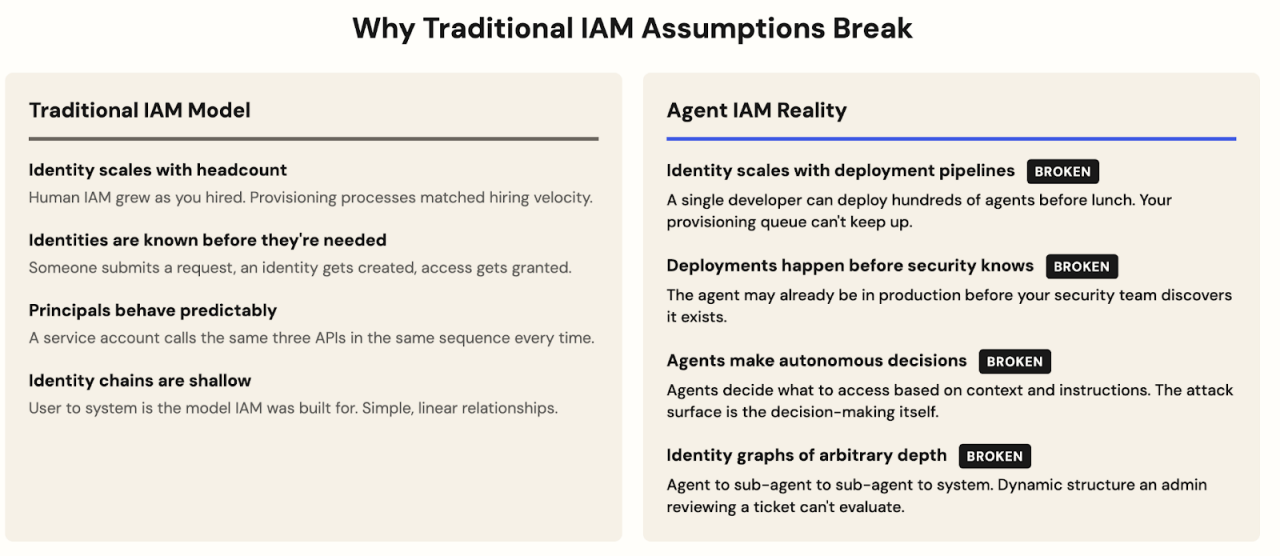 Les agents d’IA enfreignent systématiquement les hypothèses sur lesquelles la gestion des identités et des accès traditionnelle repose, nécessitant un changement architectural dans la gouvernance.
Ces écarts par rapport aux règles d’IAM traditionnelles expliquent pourquoi la solution à la question de l’embauche n’est pas de recruter des administrateurs, mais plutôt d’opter pour une architecture optimisée.
Si une entité agit, elle a besoin d’une identité
Avant d’aborder l’architecture, il existe un principe clé sur lequel tout le reste repose, et les entreprises qui font l’impasse dessus créent un problème qu’aucune quantité de personnel ou d’outils ne pourra résoudre par la suite :
Chaque agent d’IA opérant dans votre environnement a besoin de sa propre identité. Point final, sans exception.
Pas d’identifiants partagés. Pas de compte de service emprunté. Ce n’est pas une question qui se règle après le déploiement. Une identité propre doit être provisionnée avant même que l’agent n’interagisse avec un système de production.
Qu’est-ce qui constitue une identité d’agent complète ?
- Un identifiant unique et vérifiable
- Un champ d’actions autorisées défini et documenté
- Un propriétaire humain désigné qui en est responsable
- Un rapport d’audit de ses actions
- Un parcours clair vers la suspension et la résiliation
Que se passe-t-il sans cela ? Nous savons que le Shadow IT peut entraîner le stockage de données dans des emplacements non autorisés. Désormais, la Shadow AI peut conduire à des actions autonomes dans des contextes non autorisés. Vous ne pouvez pas auditer ce dont vous ignorez l’existence. Vous ne pouvez pas ajuster correctement des autorisations que vous n’avez jamais examinées. Vous ne pouvez pas résillier l’accès d’un agent qui n’a jamais été officiellement provisionné. Et vous ne pouvez absolument pas affecter une équipe suffisamment importante pour traquer des agents qui n’ont jamais été dans le système.
Chaque agent a besoin d’un lien humain
Lorsqu’un agent provoque un incident, qui appelez-vous ?
Si vous ne pouvez pas répondre à cette question, vous avez un problème de gouvernance qu’aucun effectif ne peut résoudre. Pour maintenir ce lien humain, deux concepts doivent fonctionner de concert.
- Propriété humaine. Chaque agent a besoin d’un responsable désigné au sein de votre entreprise. Pas le développeur qui l’a écrit il y a trois mois et qui a depuis été affecté à une autre équipe, ni le fournisseur qui a fourni le modèle sous-jacent. Une personne ou une équipe dont les responsabilités actuelles incluent l’approbation du champ d’application de l’agent, la notification en cas de comportement anormal et la responsabilité en cas de dommages causés. Il ne s’agit pas d’une charge administrative nécessitant une embauche dédiée, mais d’une exigence de gouvernance qui s’intègre au mode de déploiement des agents.
- Délégation et chaîne d’autorité. Lorsqu’un agent entreprend une action, l’une des deux affirmations suivantes doit être vraie : il agit dans le cadre de ses propres autorisations explicitement définies, ou il agit sur la base d’une autorité qui lui a été explicitement déléguée par un humain. Les deux sont légitimes. Les deux doivent être traçables.
Cependant, dans les systèmes multi-agents, cette chaîne peut rapidement devenir complexe :
Un humain approuve un workflow → un agent orchestrateur agit sur cette approbation → un sous-agent est invoqué avec un champ d’application délégué → un appel d’API atteint un système sensible.
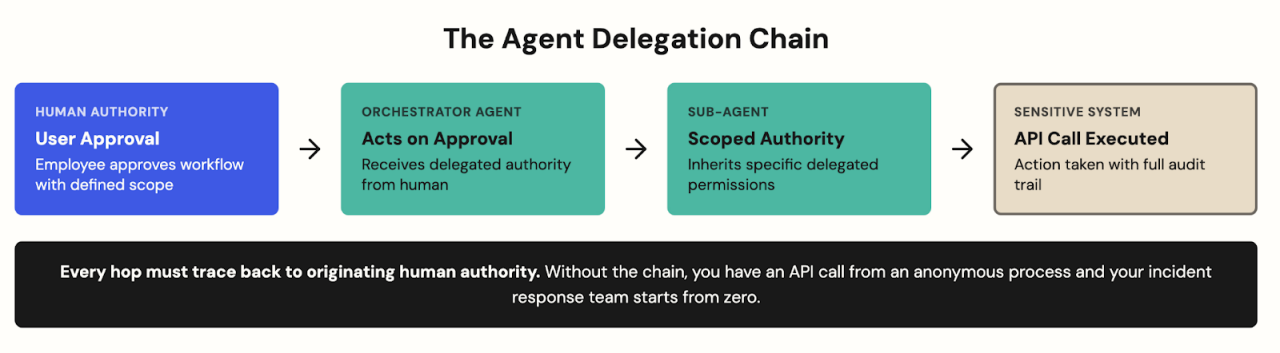 Chaque action dans un workflow multi-agent doit être traçable jusqu’à l’autorité humaine d’origine. Sans la chaîne, la résolution des incidents part de zéro.
Chaque maillon de cette chaîne doit être traçable jusqu’à l’humain d’origine. Non seulement parce que les organismes de réglementation l’exigent, mais aussi parce que lorsqu’un problème survient, vous devez reconstituer exactement ce qui s’est passé, pourquoi l’agent pensait qu’il disposait des autorisations nécessaires et où le problème s’est produit. Sans la chaîne, vous avez un appel d’API provenant d’un processus anonyme et votre équipe de résolution des incidents part de zéro.
La propriété détermine qui est responsable. La délégation précise quelle autorité est utilisée. Ensemble, elles permettent de s’assurer qu’aucun agent ne fonctionne sans qu’un humain n’en soit responsable. Aucun de ces concepts ne nécessite une armée d’administrateurs pour être appliqué s’il est correctement intégré dès le départ.
Connecter les développeurs et les gardiens
Deux équipes sont au centre de ce problème, avec des motivations différentes et, souvent, un chevauchement limité.
- Les développeurs réagissent rapidement, évalués sur la base de la distribution, en résolvant les problèmes métier avec de nouvelles fonctionnalités impressionnantes. La gouvernance des identités n’est pas leur priorité principale : ce qui compte, c’est de distribuer rapidement des fonctionnalités innovantes.
- Les équipes sécurité, IAM et conformité sont responsables du niveau de risque. Elles découvrent souvent l’existence de nouveaux agents après le déploiement, parfois longtemps après. Elles sont responsables des risques que vous n’avez généralement pas contribué à créer.
Cette tension n’est pas nouvelle. Elle est apparue avec le cloud, les terminaux mobiles et le Shadow IT. Mais les enjeux sont plus importants avec les agents. Un conteneur de stockage cloud mal configuré peut exposer des données de façon passive. Un agent mal configuré peut agir activement, et le rayon de déflagration est radicalement différent.
La mauvaise approche pour les équipes sécurité consiste à créer un goulet d’étranglement nécessitant un examen manuel pour chaque déploiement d’agent. Au-delà du ralentissement général, cette approche a un taux de défailllance historique de 100 %. Les développeurs la contournent, et vous vous retrouvez avec des agents sans gouvernance au lieu d’agents sous gouvernance. Accessoirement, il s’agit exactement du modèle qui requiert l’embauche de davantage d’administrateurs pour suivre le rythme de déploiement.
La bonne approche consiste à partager la propriété avec une application automatisée : les équipes sécurité définissent à l’avance les politiques et les garde-fous ; les équipes développement déclarent le champ d’application et la propriété au moment du déploiement ; le pipeline gère le provisioning automatiquement. La sécurité gagne en visibilité sans être sur le parcours critique. Les développeurs gagnent en rapidité sans contourner les contrôles. Et votre équipe identité consacre son temps à élaborer des frameworks de gouvernance plutôt qu’à traiter des tickets.
À quoi ressemblent les bases de la sécurité des identités des agents d’IA
Revenons donc à notre question initiale : « Ces histoires d’agents d’IA ont l’air géniales. Mais combien d’administrateurs d’identité vais-je devoir embaucher pour gérer tout ça ? »
Réponse : vous n’avez pas besoin d’adapter la taille de votre équipe identité proportionnellement à votre flotte d’agents. Vous devez poser des bases capables d’évoluer sans eux.
Ces bases reposent sur quatre piliers.
- Identité des agents sous forme de code. L’identité des agents ne doit pas être une étape de provisioning manuelle. Il devrait s’agir d’un artefact de déploiement, défini dans un manifeste en parallèle du code de l’agent, examiné dans le cadre du processus de développement et provisionné automatiquement lors de la distribution de l’agent. Le contrôle de sécurité a lieu pendant la révision du code, avant la production, et non après, en tant qu’étape administrative distincte.
- Gouvernance basée sur les catégories. Vous ne gérerez jamais directement des millions d’agents. Vous gérerez des dizaines de catégories d’agents. Une catégorie définit les systèmes et l’accès aux données autorisés, le niveau maximal de classification des données, les cas où une intervention humaine est nécessaire, et les exigences en matière d’audit. Les agents individuels héritent automatiquement des catégories. Votre gouvernance évolue en fonction du nombre de catégories que vous gérez, et non du nombre d’instances en cours d’exécution à un moment donné.
- Aucun privilège permanent. Les agents ne doivent détenir aucune autorisation persistante. Chaque action nécessite des identifiants limités dans le temps et couvrant une tâche spécifique. Une fois la tâche terminée, les identifiants expirent. Cela ne réduit pas seulement votre surface d’attaque — cela rend également le problème d’échelle plus facile à gérer. Il n’y a pas de prolifération des droits pour des milliers d’agents, qu’il faudrait examiner et nettoyer. Chaque émission d’identifiants est un événement de gouvernance avec un enregistrement automatique.
- La chaîne de délégation comme infrastructure. Les workflows multi-agents doivent considérer les chaînes de délégation comme une préoccupation architecturale de premier ordre, et non comme une réflexion secondaire. Lorsque l’infrastructure est appliquée de manière technique, vous bénéficiez automatiquement d’une traçabilité. Quand un principe de conception doit être vérifié manuellement, cela peut devenir un travail à temps plein.
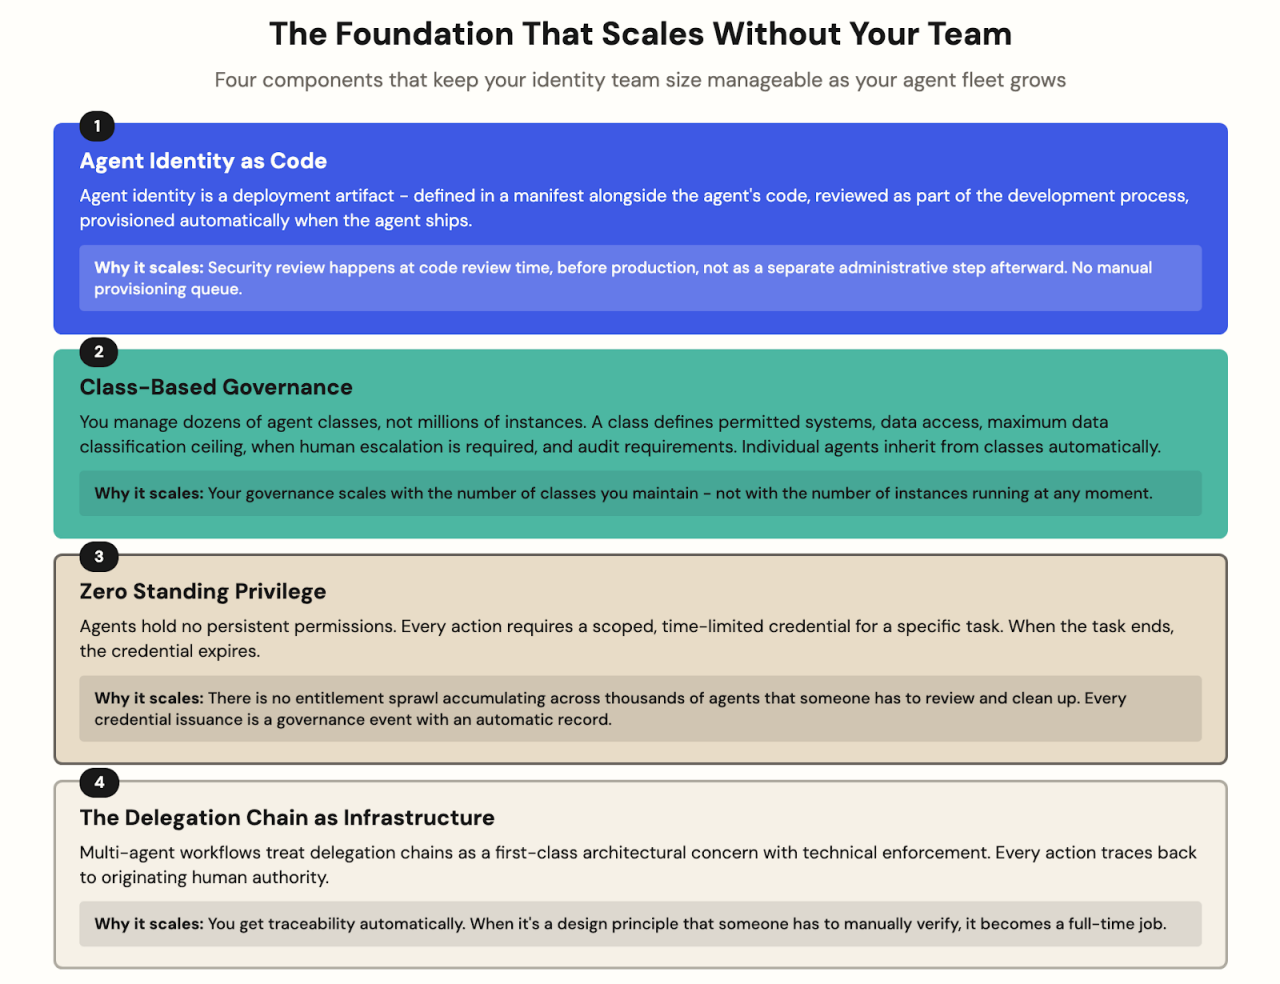 Les bases qui permettent de faire évoluer la gouvernance des agents d’IA sans que votre équipe identité ne s’agrandisse linéairement avec votre flotte d’agents.
L’identité n’a jamais été une affaire ponctuelle, et les agents d’IA ne font pas exception
Le provisioning d’une identité d’agent au moment du déploiement n’est que le début de la gouvernance, et non la fin. Ici aussi, la réponse réside dans l’automatisation et la discipline, et non dans l’augmentation des effectifs.
- Les cycles d’évaluation des accès doivent inclure les agents. Cet agent est-il toujours actif ? Son champ d’application est-il toujours approprié ? Le contexte métier a-t-il changé ? Automatisez la collecte de données. Confiez les décisions concernant les exceptions à des humains. N’élaborez pas un processus qui exige qu’une personne examine manuellement des milliers d’agents chaque trimestre ; créez plutôt un processus qui n’identifie que ce qui nécessite un jugement humain.
- Ajustez les autorisations en fonction du comportement réel. Les agents sont souvent provisionnés avec un champ d’application plus étendu que celui qu’ils finissent par utiliser. Les données d’utilisation indiquent ce à quoi un agent accède réellement par rapport à ce qu’il est autorisé à consulter. Laissez le système identifier l’écart. Faites approuver la réduction par des humains. Voici comment éviter la multiplication des autorisations qui finit par nécessiter un effort administratif important pour les démêler.
- La mise hors service est une opération de premier ordre. Lorsqu’un workflow est mis hors service, ses agents doivent être désactivés automatiquement. Les agents zombies, déployés et oubliés, mais disposant toujours d’identifiants, représentent l’un des modèles à plus haut risque dans les environnements agentiques. Ils sont également la conséquence directe du fait de considérer la mise hors service comme un processus manuel auquel on finit par se consacrer.
La réponse à la question
Combien d’administrateurs d’identité faut-il donc embaucher pour gérer des milliers d’agents d’IA ?
Si vous posez correctement les bases, pas autant que vous le pensez, et bien moins que ce dont vous auriez besoin sans cela.
Ce dont vous avez réellement besoin, c’est d’un petit nombre de personnes capables de créer des frameworks établissant des politiques de sécurité, de développer des intégrations de pipeline, d’interpréter les signaux comportementaux à grande échelle, et de tenir les équipes développement responsables des standards de gouvernance.
Ce dont vous n’avez pas besoin (et ce qui ne fonctionnera de toute façon pas), c’est d’une nouvelle équipe qui provisionne, examine et met hors service manuellement les identités des agents à partir d’une file d’attente de tickets. Ce modèle s’effondre sous son propre poids avant même d’atteindre une centaine d’agents, sans parler d’un millier.
Les entreprises qui assurent une gouvernance appropriée d’agents d’IA à grande échelle ne seront pas celles qui ont embauché le plus rapidement. Ce seront celles qui auront jeté les bonnes bases le plus tôt possible, alors que la flotte était encore suffisamment petite pour être façonnée, et avant que la question de l’embauche ne devienne impossible à résoudre.
Cinq choses à faire avant que votre flotte d’agents ne s’agrandisse :
- Déclarez le principe en interne : chaque agent se voit attribuer une identité, sans exception, dès à présent.
- Inventoriez ce qui est déjà en cours d’exécution, y compris ce que vous n’avez pas officiellement déployé.
- Exigez l’attribution d’un propriétaire humain pour chaque agent actuellement en production.
- Définissez vos niveaux de classification d’agents avant d’en avoir besoin à grande échelle.
- Faites de l’identité une exigence de déploiement, et non une vérification post-déploiement.
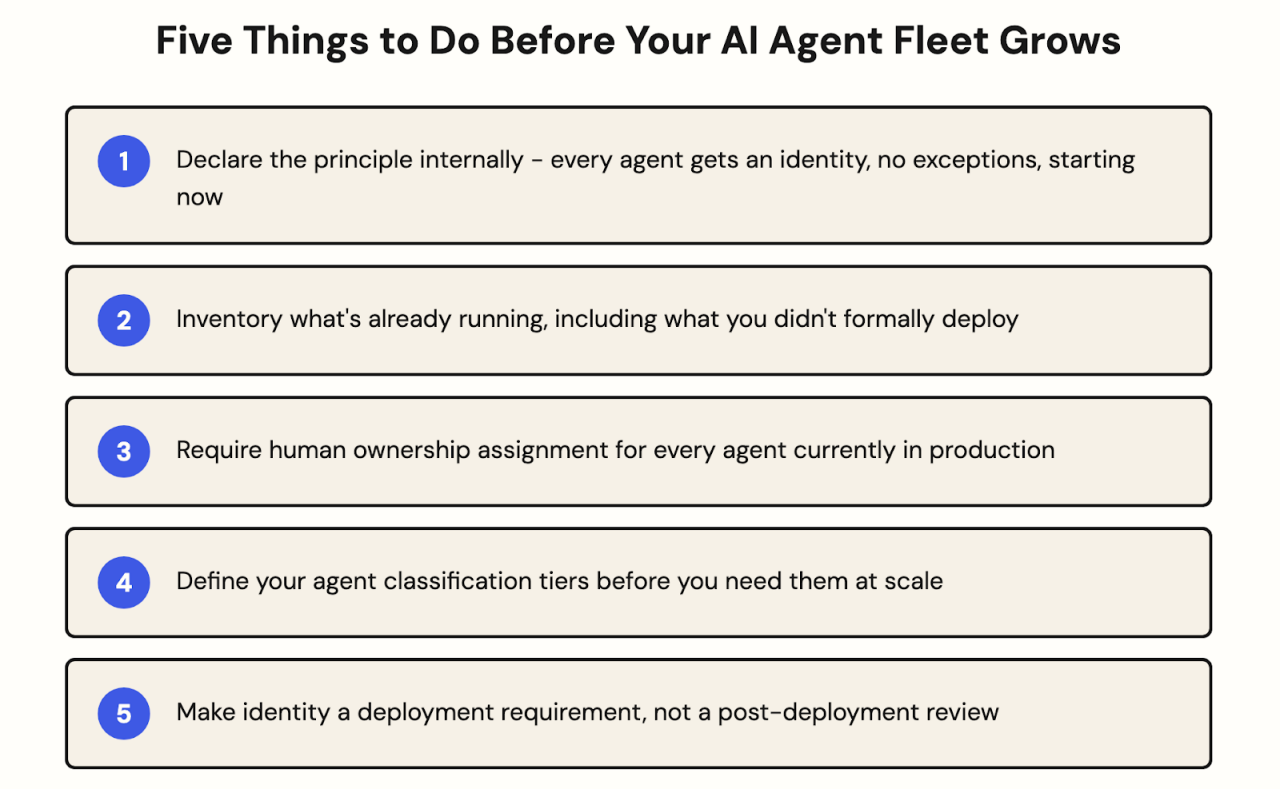 Mesures concrètes que les responsables sécurité et IT devraient prendre dès maintenant, alors que la flotte d’agents est encore suffisamment réduite pour être façonnée.
L’explosion des agents n’est pas un problème à gérer ultérieurement. Les agents arrivent désormais dans les environnements de production d’entreprises qui n’ont pas encore déterminé comment en assurer la gouvernance.
Vous avez aujourd’hui l’opportunité de bien faire les choses. Et la réponse n’a jamais été plus de personnes, mais toujours une architecture optimisée.
Êtes-vous en train de poser les bases de la gouvernance de vos agents d’IA ? Okta comble la faille en permettant aux développeurs d’accélérer le déploiement et en offrant aux équipes sécurité une gouvernance évolutive. Pour en savoir plus, cliquez ici.


