




La mission d’Okta est de permettre à tous d’utiliser les technologies qu’ils souhaitent, en toute sécurité. Okta gère des milliards d’authentifications par mois, aidant les utilisateurs à accéder en toute sécurité à leurs applications préférées. Okta bloque également des milliards de requêtes malveillantes chaque mois, protégeant les identités de ses clients contre les attaques.
Okta Platform dispose d’une stratégie de défense multicouche pour protéger les identités. Les risques représentent un aspect clé d’une telle stratégie de défense en profondeur. Okta Platform calcule les risques à différents niveaux et constitue un élément essentiel de notre stratégie de défense. Nous recommandons vivement aux clients de configurer des politiques basées sur les risques pour exiger le MFA lors des connexions à haut risque.
L’évaluation des risques liés à l’identité chez Okta est aujourd’hui alimentée par ce que l’on attend d’une entreprise de sécurité mature : notre pile ML. Nous prenons chaque événement pertinent lié à l’authentification ou à l’identité, le transformons en un enregistrement structuré (IP, terminal, agent utilisateur, pays, etc.), concevons manuellement un ensemble important de caractéristiques et les intégrons dans un modèle de machine learning.
À terme, cela alimente l’évaluation des risques liés à l’identité dans des produits tels qu’Identity Threat Protection d’Okta AI, en évaluant continuellement les risques utilisateur et session à l’aide des signaux du réseau, des terminaux et autres.
Cependant, avec l’avènement des LLM, nous avons commencé à tester de nouvelles approches et à nous demander comment nous pourrions les exploiter pour l’évaluation adaptative des risques. Après tout, les journaux de sécurité sont fondamentalement des séquences de texte structuré : types d’événements, adresses IP, agents utilisateurs, identifiants d’organisation, signaux géographiques, et plus encore. Au lieu de compresser toutes ces informations en un vecteur de caractéristiques fixe, pouvons-nous traiter les journaux comme un flux de texte natif et utiliser un LLM pour procéder à une évaluation des risques liés à l’identité directement à partir des données des journaux système ?
Cet article décrit une de ces expériences : un système d’évaluation adaptative des risques basé sur un LLM, qui apprend les schémas séquentiels et émet des scores d’anomalie en utilisant un objectif probabiliste.
Évaluation traditionnelle par machine learning
Un flux d’authentification ne produit pas un seul événement ; il produit une chronologie d’événements connexes. Pour une identité unique, un aperçu de cet historique pourrait ressembler à ceci (simplifié) :
t₁ : event_type=user.session.start …
t₂ : event_type=user.authentication.sso country=Allemagne
ip_address=145.224.xxx.xxx user_agent_raw=SFDC-Callout/64.0
browser=INCONNU os=Inconnu device=Inconnu as_org=amazon.com inc.
request_uri=/oauth2/.../v1/token …
t₃ : event_type=inline_hook.response.processed …
t₄ : event_type=user.authentication.sso …
t₅ : event_type=user.session.end …
Au fil du temps, l’historique de l’utilisateur devient une séquence :
[e1, e2, …, e(n−1), en]
Dans le pipeline traditionnel, nous n’intégrons presque jamais ces événements bruts directement dans un modèle. Cependant, nous réduisons la séquence en caractéristiques techniques calculées sur des fenêtres de temps ou d’historique, par exemple :
- « Cette adresse IP est-elle nouvelle pour cet utilisateur ? »
- « Cet ASN est-il nouveau pour cette organisation ? »
- « Avons-nous déjà vu des agents utilisateurs similaires par le passé ? »
- … et plus encore
L’événement entrant devient un vecteur de caractéristiques numériques par rapport à l’historique passé de l’utilisateur, par exemple :
caractéristiques(événement) → x ∈ ℝᵈ
Un modèle apprend un mapping :
risques = f(x)
où f est généralement un modèle de machine learning.
Le problème, c’est que l’historique des événements pour cette identité est compressé en une poignée de compteurs et d’indicateurs (appelés aussi caractéristiques). Le modèle ne « voit » pas vraiment l’historique de l’identité au fil du temps ; il voit un instantané ainsi que quelques chiffres agrégés. L’aspect séquentiel est également perdu lors de cette compression.
Pourquoi les LLM ?
Les LLM excellent dans ce que représentent précisément les journaux de sécurité : des séquences de texte semi-structuré. Au lieu d’examiner une connexion de manière isolée, un LLM peut analyser une chronologie regroupant tous les événements importants pour un utilisateur ou un agent :
« Cette identité s’authentifie généralement depuis l’Allemagne, via un client API, pendant les heures de bureau, avec une chaîne d’agent utilisateur très spécifique… »
À partir de là, le modèle peut implicitement apprendre :
- À quoi ressemble la « normalité » pour chaque identité
- Quelles combinaisons de champs ont tendance à co-apparaître
- Lorsqu’un nouvel événement s’écarte de cette base de référence de manière subtile
- Si un nouvel événement constitue même une anomalie à l’échelle mondiale
Il y a trois avantages majeurs :
- Séquences
Les LLM peuvent lire plusieurs événements dans l’ordre, et pas seulement un simple instantané. Ils considèrent toute la séquence comme une histoire et jugent si le chapitre suivant a du sens. - Moins d’ingénierie manuelle des caractéristiques
Au lieu de concevoir des centaines de caractéristiques manuellement, nous laissons le modèle apprendre les schémas directement à partir du texte des événements bruts. Cela permet de gagner du temps d’ingénierie.
- Meilleure généralisation à de nouveaux schémas
Étant donné que le modèle voit des séquences complètes, il peut signaler des combinaisons surprenantes qu’il n’a jamais vues pour cette identité, même si nous n’avons pas créé de caractéristique pour ce schéma spécifique.
Cela signifie qu’au lieu d’aplatir toutes les informations en un seul instantané, nous pouvons fournir à un modèle LLM optimisé la séquence complète des événements pour un utilisateur ou un agent et demander : compte tenu du comportement habituel de cette identité, cet événement suivant semble-t-il normal ou étrange ?
Globalement, le système comporte deux parties clés :
- Apprendre à un LLM à prédire l’événement suivant en fonction du profil historique de l’utilisateur ainsi que des événements et tokens précédents
- Utiliser la surprise du modèle comme score d’anomalie/de risque
Nous les aborderons ensuite.
Optimisation des LLM
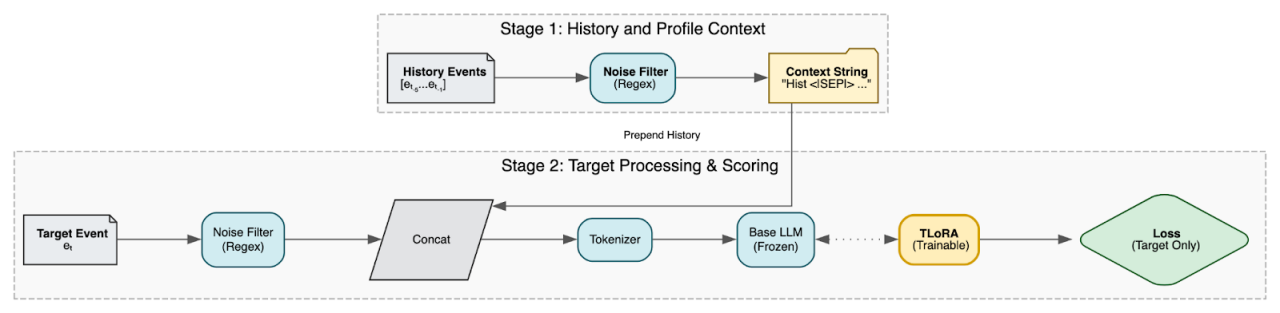
L’optimisation d’un LLM est essentiellement un moyen de lui enseigner les schémas que nous observons quotidiennement dans les données d’identité d’Okta. La configuration expérimentale que nous utilisons comprend trois étapes : établir un contexte historique ou un profil pour l’utilisateur, adapter le LLM à ce profil et l’entraîner à prédire l’événement suivant.
1. Transformation de l’historique des événements en un profil
Pour une identité donnée, nous commençons par une séquence d’événements passés :
historique = [e₁, e₂, …, eₙ₋₁]
événement actuel à évaluer = eₙ.
Au lieu de convertir ces données en vecteurs abstraits, nous traitons la séquence de texte brut comme le profil. Cependant, les journaux bruts contiennent du bruit à haute entropie (ID de transaction aléatoires, hachages, nonces) qui perturbe le modèle. Nous faisons passer chaque événement dans un filtre de bruit qui remplace ces valeurs aléatoires par des espaces réservés statiques (p. ex., <ID>).
Ces séquences de texte nettoyées sont utilisées pour créer un profil p. Celui-ci capture « à quoi ressemble généralement cette identité » à travers son historique récent : pays, ASN, agents utilisateurs et schémas de flux, dans un format que le LLM peut lire nativement.
2. Conditionnement d’un modèle de langage au profil
Nous prenons ensuite un modèle de langage de type GPT et modifions l’entrée afin qu’elle ne se contente pas de voir l’événement eₙ, mais aussi le contexte historique p.
Pour cela, nous avons recours à des invites contextuelles. Nous concaténons les événements historiques (profil) avec l’événement cible, en les séparant avec un token spécial. Ainsi, au lieu que le modèle ne voie que la cible :
[tokens(eₙ)]
Il visualise le récit comportemental complet :
[tokens(e₁), tokens(e₂), ..., tokens(eₙ)]
Ceci force le modèle à encoder : « voici le comportement séquentiel de cette identité ; prédis les tokens suivants dans ce contexte ».
Pour garantir une meilleure efficacité, nous ne réentraînons pas l’intégralité du modèle de langage. Nous figeons le modèle de base et ajoutons de petites couches adaptateurs de faible rang. Nous utilisons une méthode d’optimisation développée en interne appelée TLoRA. Seuls les adaptateurs sont entraînés, ce qui permet de réduire l’empreinte.
3. Objectif de l’entraînement
Les données d’apprentissage proviennent de séquences d’historiques d’événements réels. Pour chaque séquence :
- Nous alimentons le modèle avec la séquence complète Profil + Cible.
- Nous calculons la perte exclusivement sur l’événement cible eₙ.
Nous entraînons le modèle en utilisant un objectif standard de modélisation linguistique (prédiction du prochain token) : il attribue une probabilité élevée à chaque token du dernier événement, compte tenu de l’historique spécifique de l’utilisateur. Le modèle est récompensé lorsqu’il anticipe correctement la prochaine action de l’utilisateur en fonction de son comportement passé et pénalisé lorsqu’il est surpris.
À travers de nombreuses identités et séquences, le modèle apprend une notion d’« événement suivant normal » conditionnée au profil spécifique de l’utilisateur p.
Évaluation des risques basée sur la perplexité
Une fois le modèle entraîné, nous pouvons transformer sa « surprise » en un score d’anomalie.
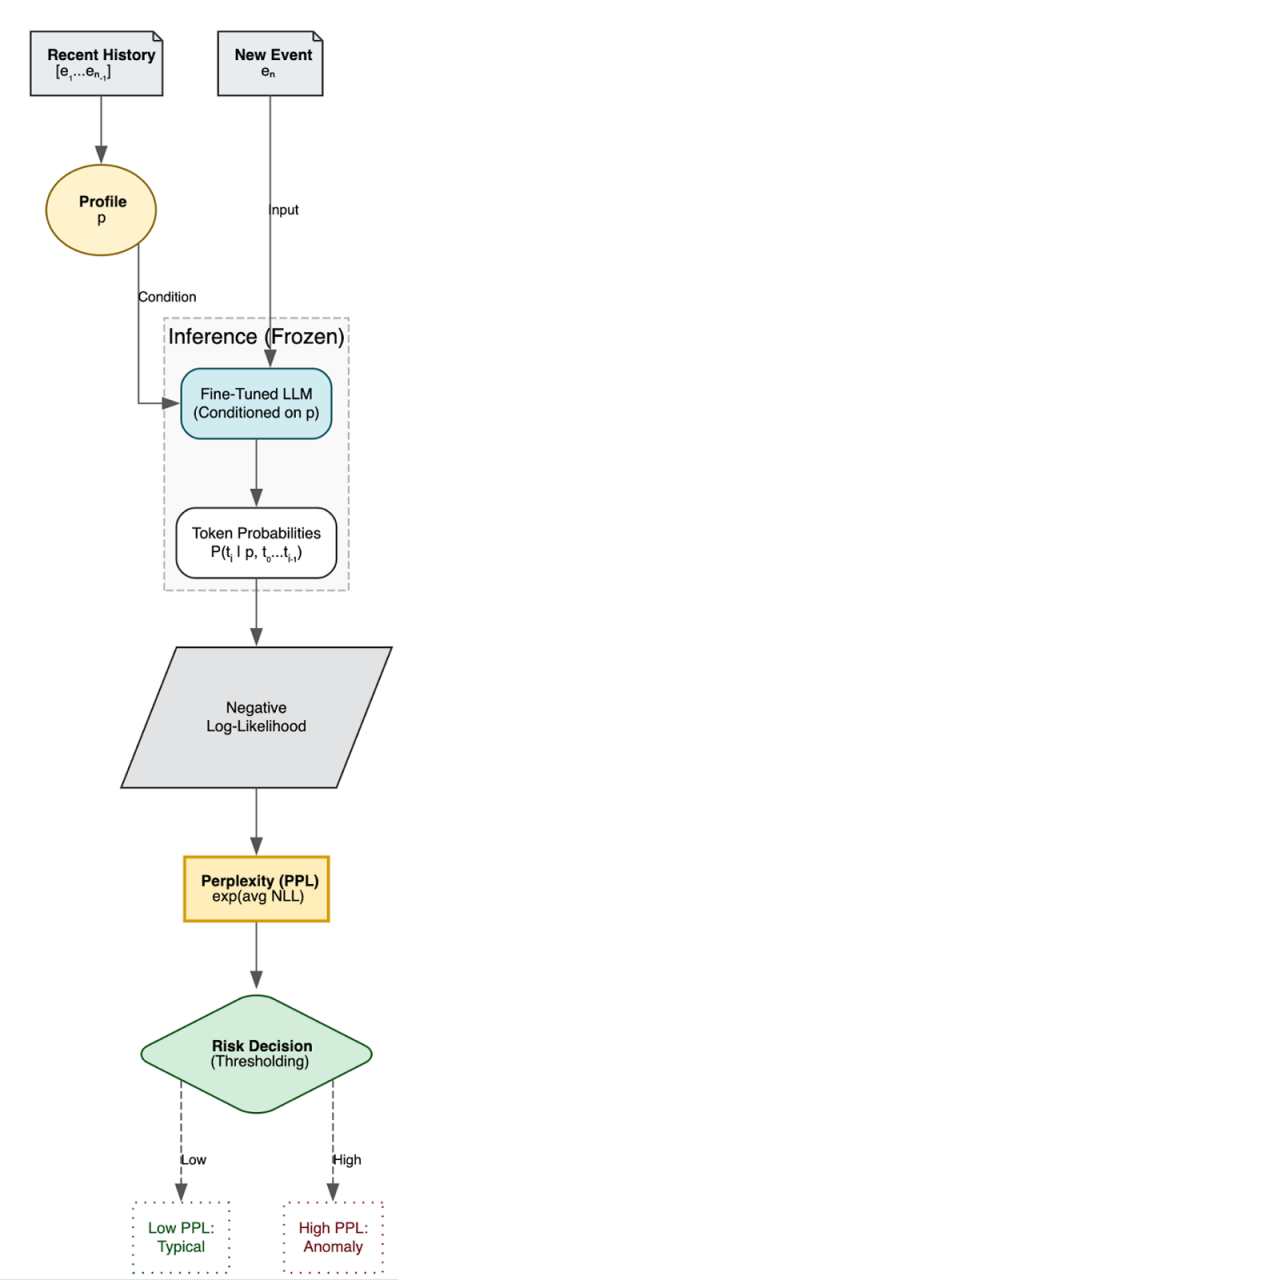
En résumé, pour un nouvel événement entrant :
- Récupérez le profil p à partir de l’historique récent de l’identité.
- Intégrez le profil et l’événement tokenisé dans le modèle.
- Posez-vous la question suivante : quelle était la probabilité de chaque token de cet événement, compte tenu du profil et des tokens précédents ?
Cela nous donne une valeur NLL (Negative Log-Likelihood) par token et une perplexité :
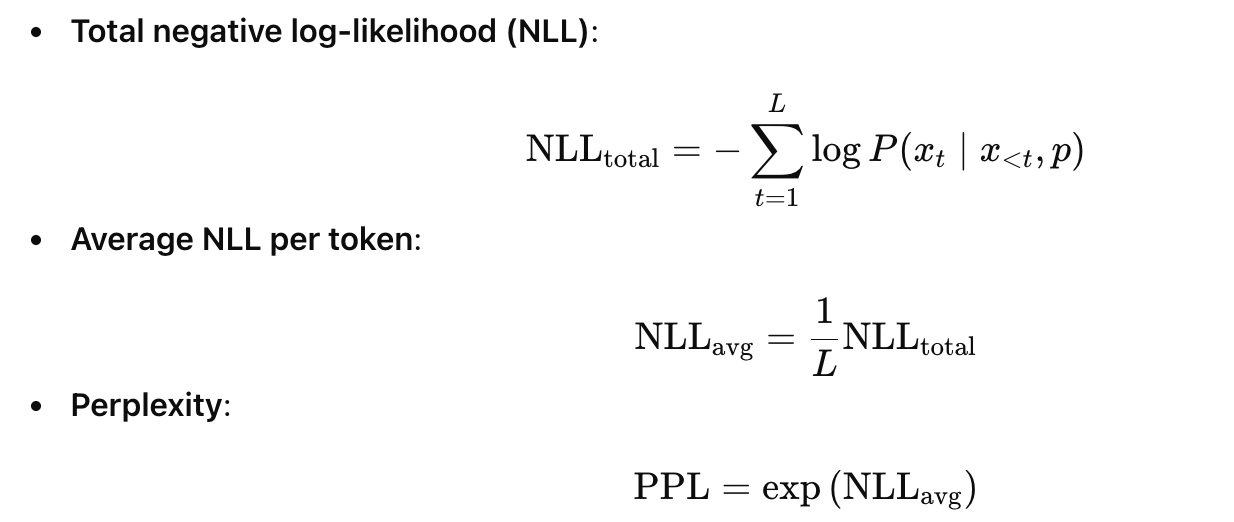
Cependant, les lignes de journal standard contiennent un texte statique significatif qui dilue le signal. Par conséquent, au lieu d’une simple moyenne globale, nous calculons la perplexité maximale. Nous isolons les K premiers tokens les plus surprenants (c’est-à-dire les valeurs NLL les plus élevées) dans l’événement cible, calculons la moyenne de ceux-ci, puis appliquons l’exponentiation. Cela garantit que le score se concentre sur les informations (pays, FAI, terminal, etc.) plutôt que sur la structure.
Sur le plan opérationnel, le score de risque est dérivé de cette perplexité :
- Perplexité faible → risque faible : l’événement semble très caractéristique de cette identité.
- Perplexité élevée → risque élevé : l’événement semble inhabituel, compte tenu de tout ce que le modèle a appris et déduit de l’historique de cette identité.
Le modèle étant conditionné au profil de chaque identité, il est intrinsèquement adaptatif.
Exemple conceptuel
Pour illustrer comment cela fonctionne en pratique, analysons une séquence réelle traitée par notre modèle.
Le modèle interprète l’historique des événements comme un récit. Il établit un « profil » pour l’utilisateur en fonction de son contexte : où il se trouve, quel terminal il utilise et comment il s’authentifie généralement. Il évalue ensuite l’événement cible pour déterminer s’il correspond à ce récit.
Vous trouverez ci-dessous un suivi simplifié d’une session utilisateur. Nous avons supprimé le bruit à haute entropie (comme les ID et les hachages) pour montrer exactement sur quoi le modèle se concentre. Ceci est une version simplifiée.
1. Le contexte (profil)
Le modèle consomme d’abord ces événements pour comprendre l’état actuel de l’utilisateur.
[T-3] Démarrage de la session xevent_type=user.session.start | country=États-Unis
[T-2] Vérification MFA event_type=user.authentication.verify |
country=États-Unis | os=Windows 10 | device=Ordinateur |
result=SUCCESS
[T-1] Authentification interne event_type=security.internal.authentication |
country=États-Unis | os=Windows 10 | terminal=Ordinateur
2. L’anomalie (événement cible)
L’utilisateur accède soudainement à l’application d’administration, mais le contexte a radicalement changé.
[T-0] Accès administrateur event_type=user.session.access_admin_app |
country=Inde | ville=Chennai | os=Android | device=Mobile
Comment le score est-il calculé ?
Lorsque le modèle traite l’événement cible, il calcule la probabilité de chaque token en fonction du profil.
Sur la base du contexte établi pour « États-Unis » et « Windows », le modèle prédit avec force que ces tokens réapparaîtront. Lorsqu’il rencontre Inde et Android à la place, la probabilité pour ces mots spécifiques chute presque à zéro. Ce décalage contextuel provoque une augmentation massive des pertes pour ces tokens, ce qui élève le score de perplexité maximale à un niveau suffisamment élevé pour signaler l’anomalie.
En utilisant la perplexité maximale, le LLM isole la contradiction sémantique : l’utilisateur ne peut physiquement pas se rendre du Kansas à Chennai instantanément et changer de terminal en cours de route.
Préparer l’avenir
Cette évaluation des risques liés à l’identité basée sur des LLM est encore en phase expérimentale, mais elle nous offre une voie concrète et mathématiquement fondée pour l’avenir :
- Nous passons de vecteurs de caractéristiques conçus manuellement à des modèles de séquences conditionnés au profil.
- Nous obtenons un score d’anomalie basé sur des principes en utilisant la valeur NLL et la perplexité, plutôt que fondé sur des pondérations de règles ad hoc.
- Nous pouvons intégrer ce score d’anomalie dans les pipelines de risques existants comme un signal supplémentaire, plutôt que de remplacer ce qui fonctionne aujourd’hui.
Les travaux futurs se concentreront sur l’amélioration de l’établissement des profils, le calibrage du mappage perplexité-risque et sur des extensions possibles, telles que la génération d’explications en langage naturel pour expliquer pourquoi un événement a été jugé surprenant.


