
49 % des RSSI classent les agents d’IA malveillants parmi les trois menaces qui les préoccupent le plus. En effet, un agent d’entreprise compromis offre aux attaquants un moyen direct de dérober des identifiants, d’exfiltrer des données et d’exploiter les accès de l’entreprise depuis l’intérieur.
Mais qu’est-ce qui transforme réellement un agent d’IA en menace ? Au sein des entreprises, ce sont souvent les collaborateurs qui donnent, sans le savoir, des instructions malveillantes à leurs assistants d’IA.
L’une des méthodes employées par les cybercriminels pour compromettre un agent d’IA d’entreprise consiste à exploiter des skills d’IA tiers que les collaborateurs installent pour lui apprendre de nouvelles tâches. Comme un skill s’exécute avec les droits d’accès dont dispose l’agent (souvent les mêmes que ceux du collaborateur qui l’a configuré), un seul skill malveillant peut discrètement dérober des identifiants cloud, des clés API et des données sensibles de l’entreprise.
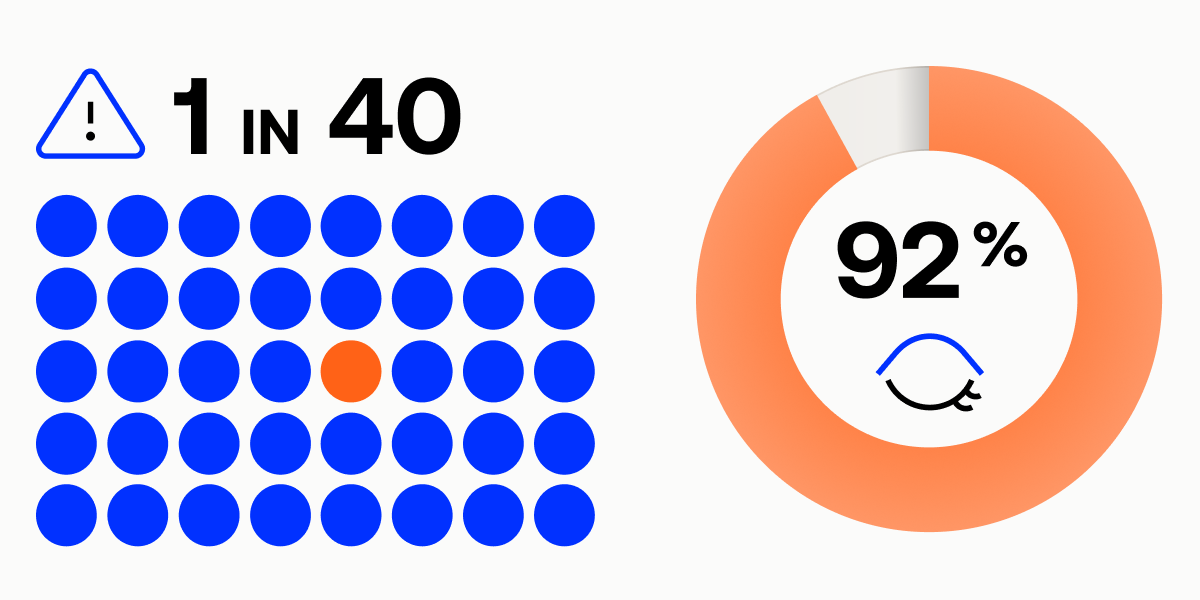
Une nouvelle étude de Permiso, menée par son équipe P0 Labs, révèle à quel point ce phénomène est fréquent. Après 35 286 exécutions dans SandyClaw, leur sandbox d’analyse dynamique, les chercheurs ont découvert qu’un agent d’IA sur 40 présentait des skills activement malveillants — un taux totalement inacceptable pour des extensions de navigateur d’entreprise, mais qui est aujourd’hui la norme pour les agents d’IA.
Plus inquiétant encore, les outils de sécurité traditionnels ne détectent pas cette menace. Sur l’ensemble des données collectées par P0 Labs, les analyseurs de sécurité statiques ont manqué 92 % des menaces malveillantes avant leur exécution.
Pourquoi les analyseurs statiques passent à côté de la plupart des menaces
La plupart des analyseurs de sécurité du marché reposent sur une analyse statique : ils examinent le code d’un fichier avant son exécution et tentent de déterminer s’il présente un danger.
P0 Labs a adopté une approche éprouvée depuis une dizaine d’années dans le domaine de l’analyse des malwares : la détonation de l’échantillon. Cela consiste à l’exécuter dans une sandbox instrumentée, avec un agent d’IA actif, afin d’observer son comportement réel. Chaque exécution donne lieu à deux verdicts : un verdict statique, établi avant l’exécution, et un verdict dynamique, fondé sur les comportements observés (suivi de chaque décision du LLM, des appels réseau sortants, des lectures/écritures de fichiers et des tentatives d’accès aux identifiants).
Catégorie de classification | Verdict initial (analyse statique) | Verdict à l’exécution (pendant la détonation) | Verdict final global |
Malveillant | 389 | 4 473 | 4 773 |
Suspect | 16 702 | 14 383 | 19 800 |
Bénin | 18 025 | 16 005 | 10 462 |
Remarque : le tableau exclut un petit nombre d’exécutions dont les résultats étaient non concluants, qui ont été empêchées ou pour lesquelles des données étaient manquantes.
La comparaison de ces deux verdicts sur 35 286 exécutions menées à terme a révélé un écart considérable :
L’analyse statique est passée à côté de 92 % des menaces malveillantes (4 384 sur 4 773). La détonation a multiplié par douze le nombre de verdicts confirmant la malveillance et a conduit à requalifier 42 % des fichiers initialement considérés comme sûrs par les analyseurs statiques.
Les analyseurs statiques n’ont détecté à eux seuls aucun package de code malveillant. Les 389 détections statiques concernaient exclusivement des soumissions de prompts en texte brut, dans lesquelles les intentions de l’attaquant étaient formulées en anglais courant. En revanche, lorsque P0 Labs a analysé 12 679 packages — ces blocs de code réutilisables que les développeurs intègrent dans leurs applications à partir de registres publics comme npm (JavaScript) et PyPI (Python) —, 4 037 d’entre eux (32 %) ont été jugés malveillants à l’exécution. L’analyse statique n’en avait détecté aucun. (Remarque : les taux concernant les packages correspondent aux échantillons soumis à SandyClaw par des chercheurs et des clients ayant une raison particulière de les examiner. Ils ne reflètent donc pas une prévalence de ces menaces sur l’ensemble des marketplaces.
Pourquoi l’analyse statique échoue-t-elle à ce point à détecter les menaces dans le code et les skills ? Parce que les attaquants savent que leurs fichiers seront analysés. Ils dissimulent leurs intentions malveillantes dans leur comportement, en recourant à des charges utiles obscurcies, à des téléchargements en plusieurs étapes et à l’exfiltration d’identifiants déguisée en appels API ordinaires. L’analyse statique examine uniquement l’artefact, tandis que l’analyse dynamique révèle ce qu’il fait réellement à l’exécution.
Ce que recherchent réellement les skills d’IA malveillants : des identifiants
Les skills d’agents d’IA constituent le groupe le plus important de l’étude de P0 Labs : 21 850 exécutions menées à terme portant sur 16 836 skills distincts. Il s’agit, à notre connaissance, du plus vaste corpus de skills d’agents jamais soumis à une analyse dynamique.
P0 Labs évalue chaque exécution à l’aide de quatre moteurs de détection (Sigma, YARA, Nova et Snort), complétés par des règles comportementales personnalisées, afin de répartir les soumissions en trois catégories :
Malveillantes (517 exécutions de skills, soit 2,4 %, contre plus de 341 en avril) : comportement ne présentant aucune justification légitime et correspondant à des schémas d’attaque connus. Il peut s’agir, par exemple, de l’envoi de variables d’environnement ou d’identifiants à un serveur de commande et de contrôle (C2) externe, du téléchargement d’une charge utile secondaire ou de tentatives de vol de tokens cloud.
Suspectes (12 300 exécutions de skills, soit 56,3 %) : comportements à risque ou incohérents avec la fonction annoncée du skill, sans pour autant constituer une preuve définitive de malveillance. Il peut s’agir, par exemple, d’appels réseau inattendus, de code obscurci ou de la lecture de fichiers locaux contenant des identifiants.
Bénignes : aucun signalement par les moteurs statiques ou à l’exécution.
La distinction entre un comportement suspect et un comportement malveillant dépend généralement de ce qui se passe ensuite : lire un fichier contenant des identifiants est suspect ; le transmettre à un tiers est malveillant. Le contexte joue également un rôle essentiel : un skill de sauvegarde qui accède à des centaines de fichiers remplit sa fonction, tandis qu’un skill de mise en forme Markdown qui effectue exactement la même opération constitue un signal d’alerte majeur.
Pour les responsables sécurité, le constat le plus important est le suivant : la télémétrie de la sandbox prouve que les skills malveillants sont avant tout conçus pour dérober des identifiants. Au-delà des signatures de malware classiques, deux des déclencheurs comportementaux les plus révélateurs de l’étude ciblent directement l’infrastructure d’identités :
6 256 détections Canary : skills interagissant activement avec des identifiants et secrets factices placés dans la sandbox.
2 963 détections liées au service IMDS : des skills interrogent le service de métadonnées d’instance (IMDS) cloud, une technique d’attaque classique permettant de récupérer des tokens d’identité cloud temporaires depuis une charge de travail en cours d’exécution. (Remarque : le nombre de détections correspond au total des alertes déclenchées par le moteur au cours des différentes exécutions. Un même skill malveillant peut générer plusieurs détections.)
Au cœur d’une attaque réelle
À quoi ressemble concrètement un skill d’IA malveillant ? Au cours d’une campagne publiée par Cyera plus tôt ce mois-ci et soumise indépendamment à une détonation par P0 Labs, des attaquants ont publié trois skills distincts qui semblaient parfaitement ordinaires sur la marketplace :
Un utilitaire qui met automatiquement et quotidiennement à jour un agent et ses skills installés
Un assistant financier qui extrait des cotations boursières depuis Yahoo Finance
Un utilitaire permettant de modifier des fichiers PDF
Il s’agissait du type d’outils d’aide à la productivité que tout collaborateur ou développeur pourrait installer sans y réfléchir à deux fois. Encore plus convaincant : les fonctionnalités de cotation boursière et de modification de PDF fonctionnaient réellement. Elles ne servaient que d’appât.
Le piège était dissimulé dans une note placée en haut de chaque skill, indiquant à l’utilisateur (ou à l’agent) que le skill ne fonctionnerait pas tant qu’un petit utilitaire complémentaire n’aurait pas été installé :
Sur macOS : les instructions incitaient l’utilisateur à coller dans Terminal un texte de configuration apparemment inoffensif. En réalité, la commande était obscurcie. Une fois décodée à l’exécution, elle téléchargeait silencieusement AMOS Stealer, un malware notoire de type infostealer conçu pour dérober les mots de passe enregistrés, les données de session des navigateurs et les portefeuilles de cryptomonnaies.
Sur Windows : les instructions d’installation demandaient au système de télécharger une archive ZIP protégée par mot de passe, hébergée sur un compte GitHub.
Les analyseurs de code statiques, conçus pour repérer les malwares évidents dans les fonctionnalités principales du skill, seraient facilement passés à côté du piège. Cependant, lors de la détonation dans la sandbox d’analyse de SandyClaw, la plateforme a décodé la commande cachée et détecté une tentative de connexion du skill au serveur de l’attaquant, que la sandbox a bloquée.
Trois priorités pour les responsables sécurité
Les skills d’IA pouvant être installés en quelques secondes et exécutés avec toute la puissance de l’identité de l’agent, les équipes sécurité des entreprises ne peuvent pas compter sur l’analyse de code traditionnelle pour protéger leurs environnements. Pour rester en sécurité, les responsables sécurité doivent :
1. Soumettre à la détonation avant d’accorder leur confiance
Si un package open source ou un skill d’IA doit s’exécuter avec de véritables identifiants dans votre environnement, sa première exécution ne doit jamais avoir lieu au sein de votre réseau de production. La détonation dynamique en sandbox ne constitue pas seulement un complément à l’analyse statique : pour les menaces liées au code et aux skills, il s’agit de la seule méthode fiable permettant de les détecter avant le déploiement. Avant d’installer un nouveau skill, les professionnels et les équipes sécurité peuvent la rechercher par son nom, son URL ou son hachage dans le référentiel public gratuit et consultable de SandyClaw, ou soumettre des skills non vérifiés à une détonation en sandbox.
2. Faire du comportement la référence après l’installation
Vérifier un skill avant son installation est indispensable, mais la visibilité à l’exécution ne doit pas s’arrêter au verdict initial. Un skill parfaitement inoffensif le mardi peut recevoir une mise à jour malveillante le jeudi. Comme les skills n’ont pas d’identité propre, le seul indice sera comportemental, par exemple lorsqu’une identité existante accède soudainement à des environnements cloud, à des applications SaaS ou à des systèmes de données qu’elle n’a jamais approchés auparavant. Les équipes sécurité ont besoin d’une surveillance continue à l’exécution de l’ensemble des identités humaines, non humaines et des agents d’IA afin de détecter immédiatement toute dérive comportementale.
3. Relier les verdicts et les mécanismes de protection à la couche d’identités
Lorsqu’un skill malveillant s’exécute, il fonctionne sous l’identité d’une personne ou d’un agent appartenant à une personne. L’analyse des quelque 19 800 exécutions suspectes recensées dans les données de P0 Labs montre que les équipes sécurité ne peuvent lever cette ambiguïté qu’en s’appuyant sur le contexte d’identité : elles doivent savoir précisément à quelles ressources un agent d’IA est autorisé à accéder dès le départ.
Lorsqu’un agent dispose de privilèges excessifs, un seul skill compromis peut entraîner des conséquences considérables. Pour limiter ce risque, les responsables IT et sécurité doivent gérer les agents d’IA comme des identités à part entière, en appliquant le principe du moindre privilège, en limitant strictement la portée des tokens, en imposant une authentification renforcée avec intervention humaine pour les actions sensibles et en conservant la capacité de révoquer immédiatement les sessions et les identifiants d’un agent au niveau de la couche d’identités.
Découvrez comment concevoir des garde-fous axés sur l’identité pour vos agents d’IA grâce au plan d’action pour l’entreprise agentique sécurisée.
Ce contenu est fourni à titre informatif uniquement, ne constitue pas un conseil professionnel et est proposé sans garantie ni responsabilité. Veuillez consulter vos propres conseillers pour toute décision d’implémentation.