



現在、ほぼすべてのCISOとCIOの受信箱に、ある質問が届いています。
「このAIエージェントの仕組みは素晴らしいようですが、それをすべて管理するには、どれだけの数のアイデンティティ管理者を雇う必要があるのでしょうか?」
それは全くもっともな質問です。また、文字通りに受け取ると、AIエージェントのガバナンスを人員配置の問題として捉える組織は失敗するため、間違った質問です。なぜかというと、人員を十分に早く採用できないからではなく(たとえできたとしても)、どれだけ人的管理を行っても、本質的にはアーキテクチャ上の問題であるため、解決には至らないからです。
重要なのは、AIエージェントの管理に必要な人数ではなく、エージェントの数が数十から数千、そしてそれ以上に増えても、管理可能な状態を維持できるような基盤をどのように構築するかです。その基盤はアイデンティティから始まり、それを構築する好機はまさに今です。
AIエージェントのアイデンティティ問題が、これまで解決してきたIAMの問題とは異なる理由
AIエージェントは、従来のアイデンティティとアクセス管理(IAM)が構築された際のあらゆる前提とルールを覆します。従来ルールの例:
- アイデンティティは従業員数や顧客数に応じて拡張する。ヒューマンIAMは、従業員を雇用したり、顧客を獲得したりするにつれて拡大していきました。エージェントIAMは、デプロイメントパイプラインに合わせて拡張します。昼食前に、一人の開発者が数百ものエージェントをデプロイできます。プロビジョニングプロセスは、この速度に合わせて設計されていません。チケット発行キューから作業するアイデンティティ管理チームも同様です。
- アイデンティティは必要になる前に認識される。従来のプロビジョニングでは、誰かがリクエストを送信し、アイデンティティが作成され、アクセス権が付与されることを前提としています。しかし、エージェントを使用する場合、セキュリティチームがその存在を知る前に、デプロイメントがすでに本番環境に移行している可能性があります。与えられなかった可視性を、人員を増やすことで得ることはできません。
- プリンシパルは予測可能な動作する。サービスアカウントは、毎回同じ3つのAPIを同じ順序で呼び出します。エージェントは、そのコンテキストと指示に基づいて、アクセスするものを自律的に決定します。攻撃対象領域は、保持している認証情報だけではなく、それが行う決定にも及びます。
- アイデンティティ連鎖は浅い。IAMは、ユーザーとアプリ間、またはユーザーとシステム間のモデルを想定して構築されました。シンプル。エージェントは、エージェント間、エージェントとツール間、またはエージェントとエージェントとアプリケーション間など、まったく新しいモデルを導入します。これにより、複雑なアクセス網が構築されます。プロビジョニングチケットをレビューする管理者は、確認できないチェーンのリスクを評価する方法がありません。
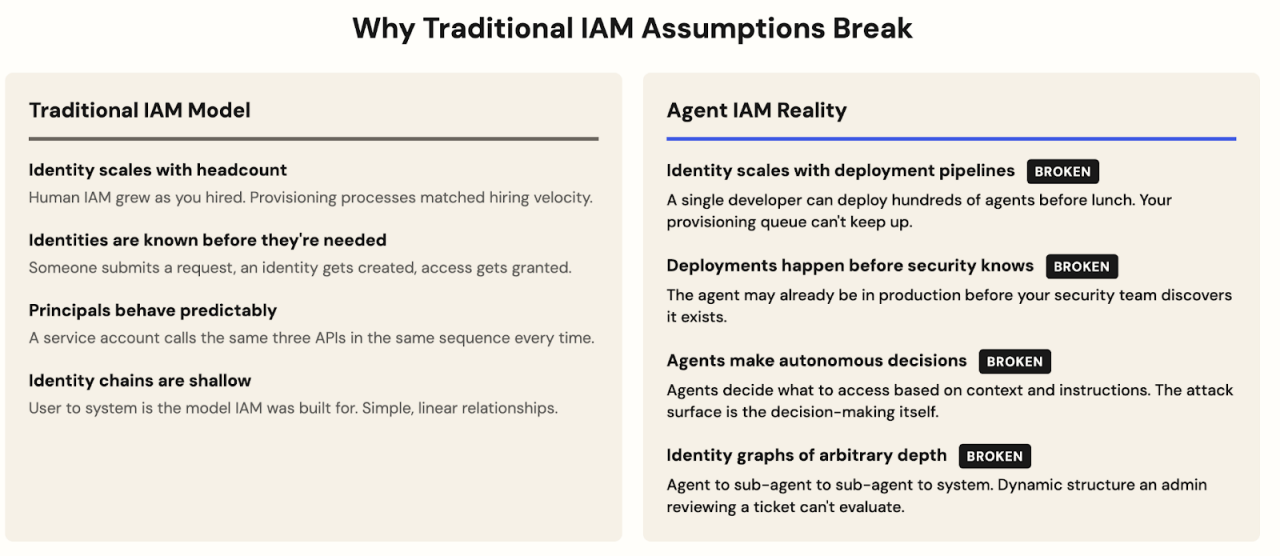 AIエージェントは、従来のアイデンティティとアクセス管理が構築された前提を体系的に覆し、ガバナンスにおけるアーキテクチャの転換を必要とします。
従来のIAMルールからの逸脱は、採用に関する問題の答えが管理者数を増やすことではなく、より優れたアーキテクチャである理由を説明しています。
動作するものには、アイデンティティが必要
アーキテクチャに入る前に、まず、他のすべての基盤となる重要な原則があります。組織がこれを無視すると、後からどれだけ人員を増やしたり、ツールを導入したりしても解決できない問題が発生します。
各環境で動作するAIエージェントは、独自のアイデンティティを必要とします。確実です。例外はありません。
共有認証情報ではありません。借用されたサービスアカウントではありません。これはデプロイ後に解決されるものではありません。本番環境システムに触れる前にプロビジョニングされる独自のアイデンティティです。
完全なエージェントアイデンティティを構成するものは何でしょうか?
- 一意で検証可能な識別子
- 許可された操作の定義済みおよび文書化されたスコープ
- 責任を持つ指名された人間の所有者
- その機能に関する監査記録
- 一時停止と失効への明確な道筋
それがなければどうなるでしょうか?シャドーITによって、データが許可されていない場所に保存される可能性があることは周知の事実です。現在、シャドーAIは許可されていない状況下で自律的な行動につながる可能性があります。存在を知らないものは監査できません。レビューしたことのない権限を適切に調整することはできません。正式にプロビジョニングされなかったエージェントのアクセス権を取り消すことはできません。そもそもシステムに存在しなかったエージェントを追いかけるために、十分な規模のチームを編成することは絶対にできません。
すべてのエージェントには、人間的なつながりが必要
エージェントがインシデントを引き起こした場合、誰に連絡しますか?
もしその質問に答えられないのであれば、それは人員を増やしたところで解決できないガバナンスの問題を抱えているということです。そのヒューマンスレッドを維持するには、2つの概念が連携して機能する必要があります。
- 人間のオーナーシップ。すべてのエージェントは、組織内で責任を負う担当者を明確に指名する必要があります。3か月前にそれを作成し、その後別のチームに移籍した開発者ではありません。基盤となるモデルを提供したベンダーではありません。エージェントのスコープを承認し、エージェントが異常な動作をした場合に通知を受け、エージェントが損害を与えた場合に責任を負う現在の担当者またはチームなのです。これは、専任の担当者を必要とする管理上の負担ではなく、エージェントの展開方法に組み込まれるガバナンス要件です。
- 委任と権限の連鎖。エージェントが操作を実行する場合、以下の2つのうちいずれかが真である必要があります。エージェントが自身で明示的に定義された権限内で行動しているか、または人間から明示的に委任された権限に基づいて行動しているかのいずれかです。どちらも正当です。両方とも追跡可能である必要があります。
しかし、マルチエージェントシステムでは、この連鎖はすぐに複雑になる可能性があります。
人間がワークフローを承認 → オーケストレーターエージェントがその承認に基づいて行動 → 委任されたスコープでサブエージェントが呼び出される → API呼び出しが機密性の高いシステムに到達します。
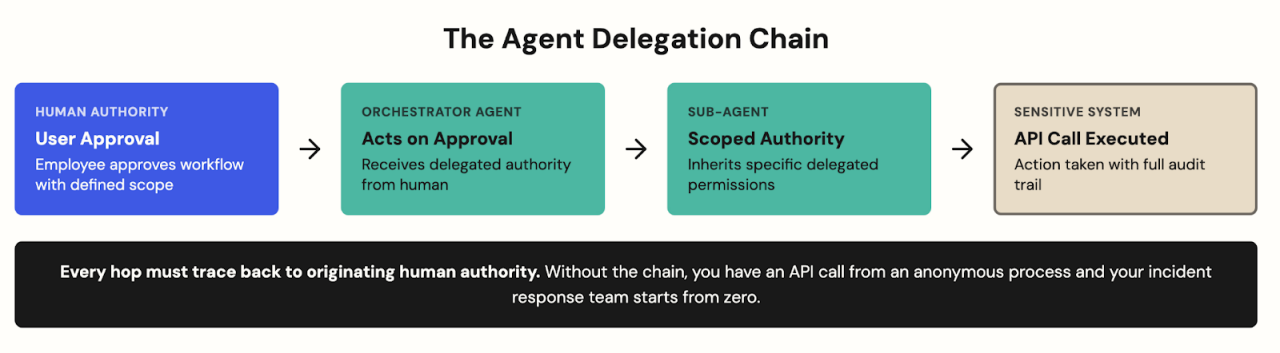 マルチエージェントワークフローにおけるすべての操作は、発信元の人間による権限に遡れるようにする必要があります。チェーンがないと、インシデント対応はゼロから始まります。
そのチェーンのすべてのホップは、元の人間にまで遡れる必要があります。規制担当者がそれを要求するからだけでなく(要求されるでしょう)、何かがうまくいかなかった場合に、何が起こったのか、なぜエージェントは承認されたと信じたのか、そしてどこで故障が発生したのかを正確に再構築する必要があるからです。チェーンがない場合、匿名プロセスからのAPI呼び出しとなり、インシデント対応チームはゼロから対応を開始することになります。
オーナーシップは、誰が責任を負うかを明確にします。委任は、誰の権限が使用されているかに答えます。両者を組み合わせることで、エージェントが、責任を負う担当者なしに動作することのないようにします。これらの概念はどちらも、基盤に正しく組み込まれていれば、大勢の管理者を必要としません。
構築者と監視者を結びつける
この問題の中心には、多くの場合、ほとんど重複しない異なるインセンティブを持つ2つのチームが存在します。
- 構築者たちは、新しい優れた機能を迅速にリリースし、ビジネス上の課題を解決します。このチームにの主要な関心事は、アイデンティティガバナンスではなく、クールなものを迅速に提供することです。
- セキュリティ、IAM、コンプライアンスの各チームがリスク姿勢を管理しています。多くの場合、新しいエージェントについて知るのはデプロイ後であり、場合によってはデプロイからかなり時間が経ってからです。このチームは通常、自分たちが関与していないリスクに対して責任を負わされています。
この緊張感は今に始まったことではありません。それはクラウド、モバイル、シャドーITで進展しました。しかし、エージェントの場合、これはさらに重要な問題です。設定が誤ったクラウドストレージバケットは、データを間接的に公開する可能性があります。構成が誤ったエージェントは、アクティブに操作を実行する可能性があり、その影響範囲は全く異なります。
セキュリティチームが誤った対応をすると、ボトルネックとなり、エージェントのデプロイごとに手動でのレビューが必要になります。このアプローチは、すべての処理を遅延させるだけでなく、100%失敗という過去歴があります。開発者はそれを回避し、管理されたエージェントではなく、管理されていないエージェントが生じてしまいます。また、それはまさに、デプロイの速度についていくためにより多くの管理者を採用する必要があるモデルでもあります。
適切な対応とは、自動化された実行による責任の共有です。セキュリティチームが事前にポリシーとガードレールを定義し、構築チームがデプロイ時にスコープと所有権を宣言し、パイプラインがプロビジョニングを自動的に処理します。セキュリティは、重要な経路に直接関与しなくても可視性を確保できます。構築者は、コントロールをバイパスすることなく、スピードを得ることができます。そして、アイデンティティチームは、チケットの処理に時間を費やす代わりに、ガバナンスフレームワークの設計に時間を費やすことになります。
AIエージェントのアイデンティティセキュリティの基盤の具体的な形
さて、元の質問に戻りましょう。「このAIエージェントの仕組みは素晴らしいようですが、それをすべて管理するには、どれだけの数のアイデンティティ管理者を雇う必要があるのでしょうか?」
答えは、エージェントの数に合わせて、アイデンティティチームを比例的に拡張する必要はありません。それなしでも拡張できる基盤を構築する必要があります。
その基盤は4つの要素で構成されています。
- エージェントアイデンティティのコード化。エージェントアイデンティティのプロビジョニングは手動で行うべきではありません。これは、エージェントのコードとともにマニフェストで定義され、開発プロセスの一部としてレビューされ、エージェントのリリース時に自動的にプロビジョニングされるデプロイメントアーティファクトであるべきです。セキュリティレビューは、コードレビュー中、本番環境に移行する前に行われ、後から別の管理ステップとして行われるものではありません。
- 階層型ガバナンス。エージェントインスタンスを数百万単位で直接管理することはありません。多数のエージェントクラスを管理することになります。クラスは、許可されるシステムとデータへのアクセス、データの最大分類上限、人的エスカレーションが必要な場合、監査要件を定義します。個々のエージェントは、クラスから自動的に継承します。ガバナンスは、特定の状況で実行されているインスタンスの数ではなく、維持しているクラスの数に応じて拡張されます。
- ゼロスタンディング特権。エージェントは永続的な許可を保持すべきではありません。すべての動作には、特定のタスクのための、スコープが限定された、時間制限付きの認証情報が必要です。タスクが終了すると、認証情報は失効します。これにより、攻撃対象領域が縮小されるだけでなく、規模の問題も解決しやすくなります。何千ものエージェントにわたって、誰かがレビューして整理しなければならないエンタイトルメントの拡大が蓄積することはありません。すべての認証情報の発行は、自動記録が伴うガバナンスイベントです。
- インフラとしての委任チェーン。マルチエージェントのワークフローでは、委任チェーンを後付けではなく、第一級のアーキテクチャ上の懸念事項として扱う必要があります。技術的に強制されたインフラストラクチャである場合、トレーサビリティが自動的に実現されます。手動で検証しなければならない設計原則は、フルタイムの仕事になってしまいます。
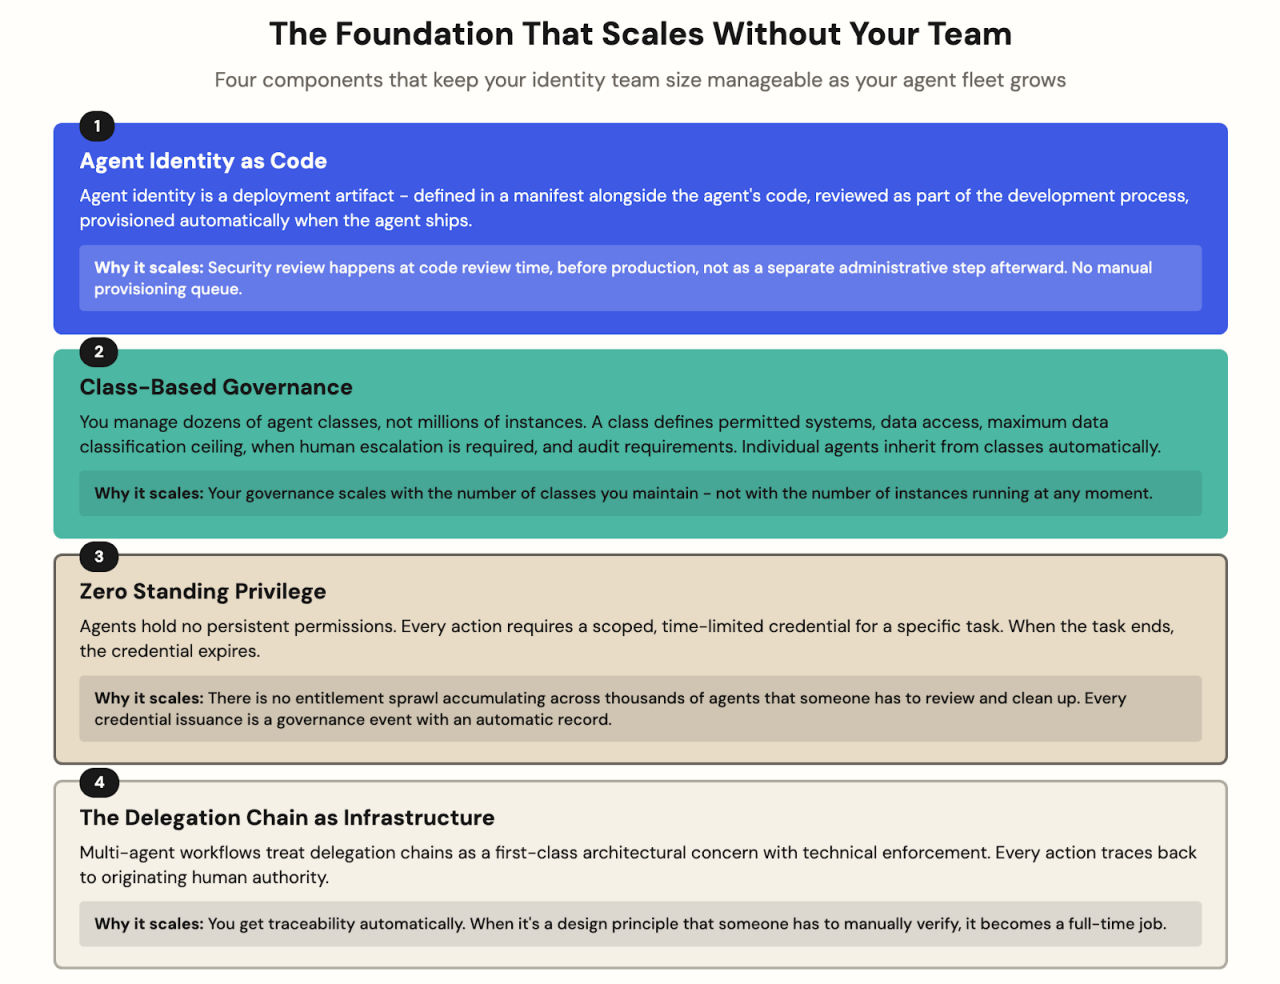 AIエージェントの数を増やすのに比例してアイデンティティチームを増員することなく、AIエージェントのガバナンスを拡張できる基盤。
アイデンティティは決して設定しっぱなしにできるものではなく、AIエージェントもそれを変えることではない
エージェントアイデンティティのデプロイ時のプロビジョニングは、ガバナンスの終わりではなく、始まりにすぎません。しかし、ここでも解決策は増員ではなく、自動化と規律です。
- アクセスレビューサイクルはエージェントを必要とする。このエージェントはまだアクティブか?そのスコープはまだ適切か?ビジネスの状況が変化したか?データ収集を自動化します。例外事項については、人が判断を下すようにします。四半期ごとに何千ものエージェントを手動でレビューする必要があるプロセスは作成しません。人間の判断が必要なものだけが表面化するように設計します。
- 実際の行動に基づいた適切な規模。エージェントは、最終的に使用するよりも広いスコープがプロビジョニングされることがよくあります。利用状況データは、エージェントがアクセスを許可されているものと、実際にアクセスするものを区別して示します。システムにその差異を特定させます。人間が削減を承認するようにします。これは、結局解決のために多大な管理作業を必要とする許可の拡大を防ぐ方法です。
- 廃止は第一級の作業。ワークフローが廃止されると、そのエージェントも自動的に廃止される必要があります。展開された後、忘れ去られたものの、依然として認証情報を持つゾンビエージェントは、エージェント環境において最もリスクの高いパターンの一つです。これらは、停止処理を手動プロセスとして扱い、誰かが最終的に行うことになるという考え方の直接的な結果でもあります。
質問への答え
さて、数千ものAIエージェントを管理するために、何人のアイデンティティ管理者を雇用する必要があるでしょうか。
基盤を正しく構築すれば、答えは「思ったほど多くはない。また、それがなければ必要となる数よりもはるかに少ない」となります。
実際に必要なのは、ポリシーフレームワークを設計し、パイプラインの統合を構築し、大規模な行動シグナルを解釈し、構築チームにガバナンス基準を遵守させることができる少数の人々です。
必要でないもの(そして、いずれにしても機能しないもの)は、新しいチームがチケット発行キューからエージェントアイデンティティを手動でプロビジョニング、レビュー、廃止することです。そのモデルは、エージェントが100人に達する前に、ましてや1000人に達する前に、自重で崩壊してしまいます。
AIエージェントを大規模に管理する組織は、最も早く人材を採用した組織ではありません。エージェントの数がまだ小さく、方向性を定めやすい時期に、そして採用に関する問題が手に負えなくなる前に、適切な基盤を最も早く構築した企業が成功するでしょう。
エージェントの数を増やす前にやるべき5つのこと
- すべてのエージェントにアイデンティティを付与し、例外なく、今すぐ開始するとの原則を社内で宣言する
- 正式にデプロイしていないものを含み、すでに実行されているものを把握する
- 現在稼働中のすべてのエージェントに、人間の責任者の割り当てを必須とする
- 大規模なエージェント運用が必要になる前に、エージェントの分類階層を定義する
- デプロイ後のレビューではなく、デプロイ要件としてアイデンティティを組み込む
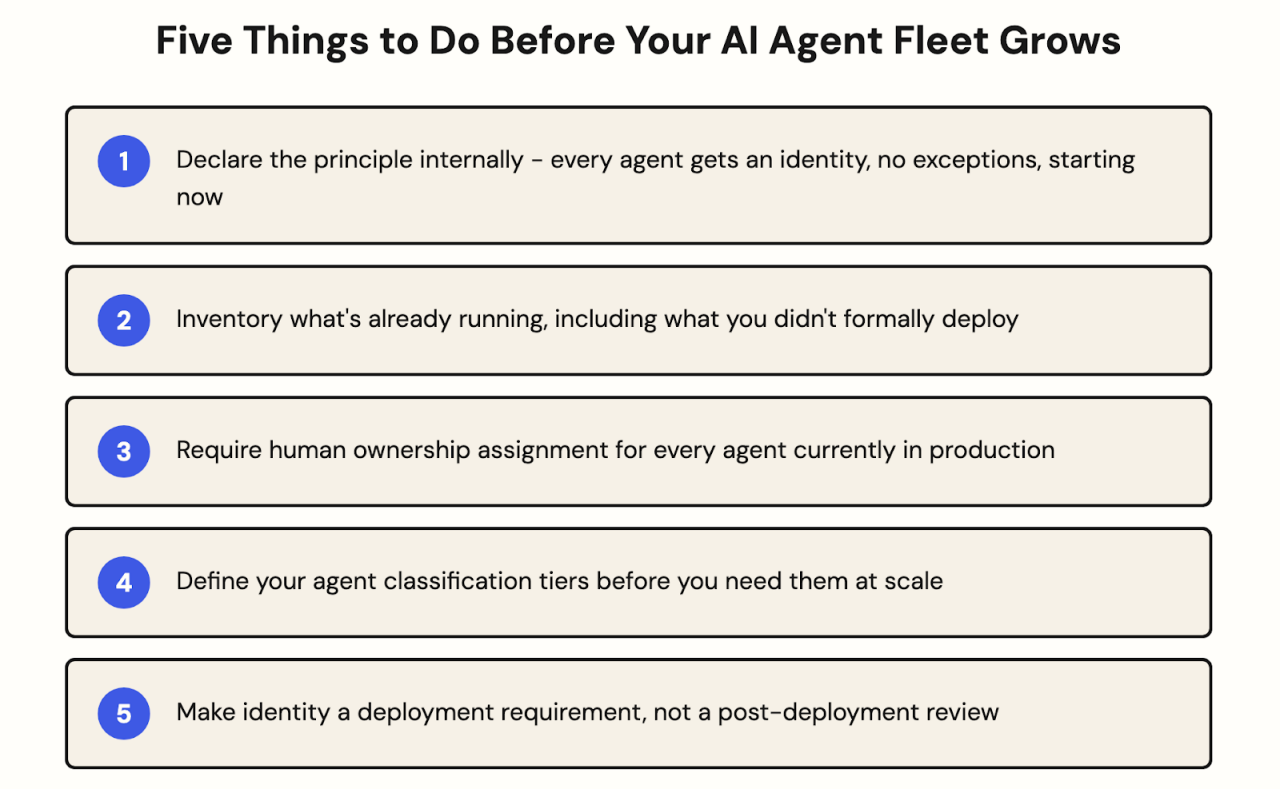 セキュリティおよびITのリーダーが、エージェント群がまだ小さく、形成しやすい段階で、今すぐ取るべき実践的なステップ。
エージェントの急増は、決して未来の問題ではありません。エージェントは現在、本番環境に導入され始めていますが、導入先の組織では、エージェントの管理方法をまだ決定していません。
これを適切に構築する機会が開かれています。そして、その答えは決して人の数を増やすことではなく、常にアーキテクチャの改善でした。
AIエージェントのガバナンス基盤を構築しますか?Oktaは、構築者がより迅速にデプロイできるようにし、セキュリティチームが拡張可能なガバナンスを提供することで、このギャップを埋めます。詳細をこちらをご覧ください。


