




Oktaは、誰もが安全にあらゆるテクノロジーを利用できるようにすることをミッションとしています。毎月、無数の認証を処理するOktaは、ユーザーがよく利用するアプリケーションに安全にアクセスできるよう支援しています。さらにOktaは毎月、絶え間なく飛んでくる悪意のあるリクエストをブロック、顧客のアイデンティティを攻撃から保護しています。
Oktaのプラットフォームは、アイデンティティを保護するために多層にわたる防御戦略を採用しています。こうした多層の防御戦略において、リスクは重要な側面です。さまざまなレベルでリスクを計算するOktaのプラットフォームは、当社の防御戦略の要所となっています。このためリスクベースのポリシーを設定し、リスクの高いログインにはMFAを導入することを強く推奨しています。
Oktaにおけるアイデンティティリスクのスコアリングは現在、成熟したセキュリティ企業として期待されるMLスタックによって支えられています。具体的には、関連するすべての認証またはアイデンティティ関連のイベントを取得、これらを構造化されたレコード(IP、デバイス、ユーザーエージェント、国名など)に変換します。また、手動で多数の機能を設計し、それらを機械学習モデルに投入しています。
最終的にはOkta AIのアイデンティティ脅威からの保護などの製品でIDリスクスコアリングを強化することで、ネットワーク、デバイス、その他のシグナルを使用してユーザーとセッションのリスクを継続的に評価します。
一方LLMの登場を受け、Oktaは新たなアプローチを試行しています。つまり「LLMをアダプティブなリスクのスコアリングにどのように活用できるか」の検討を始めています。セキュリティログとは基本的に、イベントタイプ、IPアドレス、ユーザーエージェント、組織ID、地理的シグナルなどなどの、構造化されたテキストのシーケンスに尽きます。このすべては従来、固定された機能ベクトルに圧縮してきました。一方、ログをネイティブなテキストストリームとして扱い、直接LLMを使用してシステムログデータからアイデンティティリスクのスコアリングを実行することが可能か否かは、検討する余地があります。
本記事では、これを踏まえた実験の1つとして、LLMベースのアダプティブリスクスコアリングがシーケンシャルパターンを学習し、確率的な目標を用いて異常スコアを生成するモデルを紹介しています。
従来のMLスコアリング
サインオンフローでは、1つのイベントだけを生成するのではなく、関連するイベントのタイムラインを生成します。単一アイデンティティの場合、その履歴は次のような例で示すことができます(簡略化)。
t₁: event_type=user.session.start …
t₂: event_type=user.authentication.sso country=Germany
ip_address=145.224.xxx.xxx user_agent_raw=SFDC-Callout/64.0
browser=UNKNOWN os=Unknown device=Unknown as_org=amazon.com inc.
request_uri=/oauth2/.../v1/token …
t₃: event_type=inline_hook.response.processed …
t₄: event_type=user.authentication.sso …
t₅: event_type=user.session.end …
時間の経過とともに、ユーザーの履歴は次のようなシーケンスになります。
[e1, e2, …, e(n−1), en]
従来の流れでは、こうした生イベントを直接モデルに入力することはほとんど行っていませんでした。代わりに、シーケンスを時間や履歴のウィンドウで計算した設計型機能に集約します。以下に例を示します。
- 「このIPアドレスはこのユーザーにとって新しいものか」
- 「このASNは組織にとって新しいものか」
- 「過去に同様のユーザーエージェントを見たことがあるか」
- …など
受信イベントは、ユーザーの過去の履歴を基準とした数値機能ベクトルになります。例えば次のようになります。
features(event) → x ∈ ℝᵈ
モデルはマッピングを学習します。
リスク = f(x)
ここでfは通常、機械学習モデルです。
ここでは、あるアイデンティティのイベント履歴が、複数のカウンターおよびフラグ(機能とも呼ぶ)に圧縮されていることがポイントです。このモデルは、アイデンティティの経時的な変化を「見ている」のではなく、あるスナップショットと集計された若干の数値を見ているに過ぎません。また、シーケンシャルな側面もその圧縮で失われます。
LLMを活用する理由
LLMは、まさにセキュリティログが示す、半構造化テキストのシーケンスにおいて力を発揮します。LLMは1つのログインを単独で見るのではなく、次のようなユーザーまたはエージェントについて、重要なイベントのタイムライン全体として処理することができます。
「このアイデンティティは通常、営業時間中にドイツからAPIクライアント経由で、特定のユーザーエージェント文字列を使用して認証される...」
以上の例では、モデルは暗黙のうちに以下を学習できます。
- 各アイデンティティにとっての「通常」とは何か
- どのフィールドの組み合わせが同時に発生しやすいか
- いつ新しいイベントがその基準からわずかに逸脱するか
- 新しいイベントがグローバルレベルで異常であるか否か
大きな利点としては、以下の3つです。
- シーケンス
LLMは単一のスナップショットだけでなく、シーケンス内のイベントを複数読み取ることができます。つまりシーケンス全体をストーリーとして扱い、次のチャプターが理にかなっているか否かを判断します。 - 手作業による機能エンジニアリングの削減
数百もの機能を手作業で設計する代わりに、モデルがイベントの生テキストから直接パターンを学習できるようにします。これにより、エンジニアリングにかかる時間を節約できます。
- 新しいパターンへの一般化向上
モデルは完全なシーケンスを認識、このため特定のパターンに対する機能を構築していなくても、該当するアイデンティティに対して前例のない、予期せぬ組み合わせにフラグを立てることができます。
つまり、すべてを単一のスナップショットに平坦化するのではなく、微調整したLLMモデルにユーザーまたはエージェントのイベントシーケンス全体を供給し、次のように尋ねます。このアイデンティティの通常の動作から考えると、次のイベントは正常に見えるか、それとも奇妙に見えるか
システムには大まかに2つの重要な部分があります。
- ユーザーの履歴プロファイルや先行するイベント、トークンに基づき、次のイベントを予測するようにLLMを訓練する
- モデルの驚きを異常/リスクスコアとして使用する
これらについては次に説明します。
LLMのきめ細かい調整
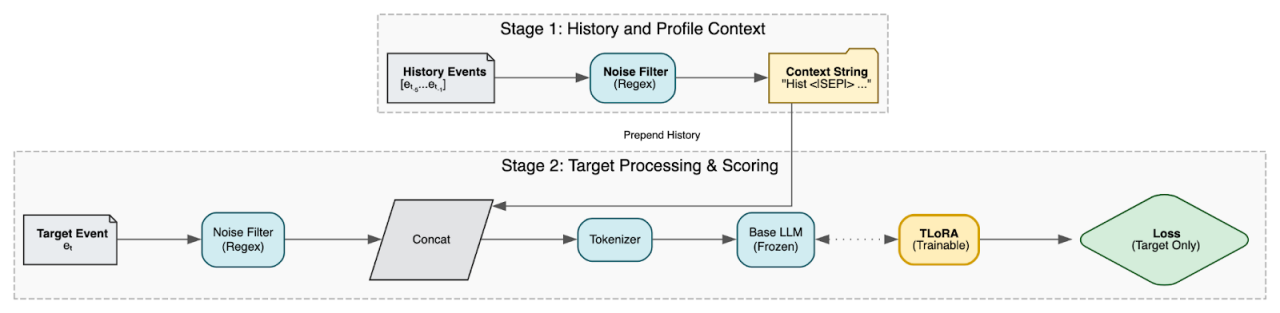
LLMのファインチューニングとは、基本的にOktaのアイデンティティデータで日常的に見られるパターンをLLMに学習させる方法です。Oktaが使用する実験的なセットアップは、まずユーザーの履歴コンテキストまたはプロファイルを作成、次にそのプロファイルに基づいてLLMを調整、次のイベントを予測するようにトレーニングする、という3つの段階で構成されています。。
1. イベント履歴をプロファイルに変換
特定のアイデンティティについて、次のような過去イベントのシーケンスから始めます。
history = [e₁, e₂, …, eₙ₋₁],
スコアリングする現在のイベント = eₙ
これらを抽象的なベクトルに変換することはせず、生のテキストシーケンスをプロファイルとして扱います。しかし、生のログにはモデルを混乱させる高エントロピーノイズ(ランダムなトランザクションID、ハッシュ、ナンス)が含まれています。各イベントをノイズフィルターに通し、ここで生じたランダムな値を静的なプレースホルダー(<ID>など)に置き換えます。
こうしてクリーニングされたテキストシーケンスは、プロファイル p の作成に使用されます。これは、最近の履歴(国名、ASN、ユーザーエージェント、フローパターン)全体にわたる「このアイデンティティが通常どのようなものか」を、LLMがネイティブに読み取れる形式で捉えたものです。
2. プロファイルに基づいて言語モデルを調整
次に、GPTスタイルの言語モデルを取り込み、イベント eₙ だけでなく、過去のコンテキスト p も見えるように入力を変更します。
文脈に応じたプロンプトを通じて、これを行います。履歴イベント(プロファイル)と対象イベントを連結し、特殊なトークンで区切ります。そのため、モデルはまず、次のターゲットを観察します。
[tokens(eₙ)]
次に、完全な行動ナラティブを観察します。
[tokens(e₁), , tokens(e₂), ... , tokens(eₙ)]
これにより、モデルに「アイデンティティの連続的な挙動を元に、そのコンテキストで次のトークンを予測せよ」とエンコードさせます。
Oktaでは、これを効率的に行うために言語モデル全体を再トレーニングすることはありません。むしろベースモデルを固定し、小さな低ランクのアダプターレイヤーを取り付けます。Oktaでは、社内で開発したTLoRAと呼ばれるファインチューニング手法を使用しています。ここではアダプターのみがトレーニングされるため、フットプリントを小さく抑えることができます。
3. トレーニングの目的
トレーニングデータは、実際のイベント履歴のシーケンスから生成されます。各シーケンスについて、次のことを行います。
- 完全なプロファイル+ターゲットシーケンスをモデルに供給します。
- 損失はターゲットイベント eₙ のみに基づいて計算されます。
モデルのトレーニングには、標準的な言語モデリングの目的(Next Token Prediction: 次トークン予測)を使用します。これは、ユーザーの特定履歴が与えられた場合に、最後のイベントの各トークンに高い確率を割り当てるものです。このモデルでは、ユーザーの過去の行動に基づいて次の行動を正しく予測すると報酬が与えられ、予測に反した場合はペナルティが科せられます。
多数のアイデンティティとシーケンスを通じて、モデルはユーザー固有のプロファイル p を条件とした「通常の次イベント」という概念を学習します。
Perplexityに基づいたリスクスコアリング
モデルのトレーニングが完了すると、その「意外性」を異常スコアに変換できます。
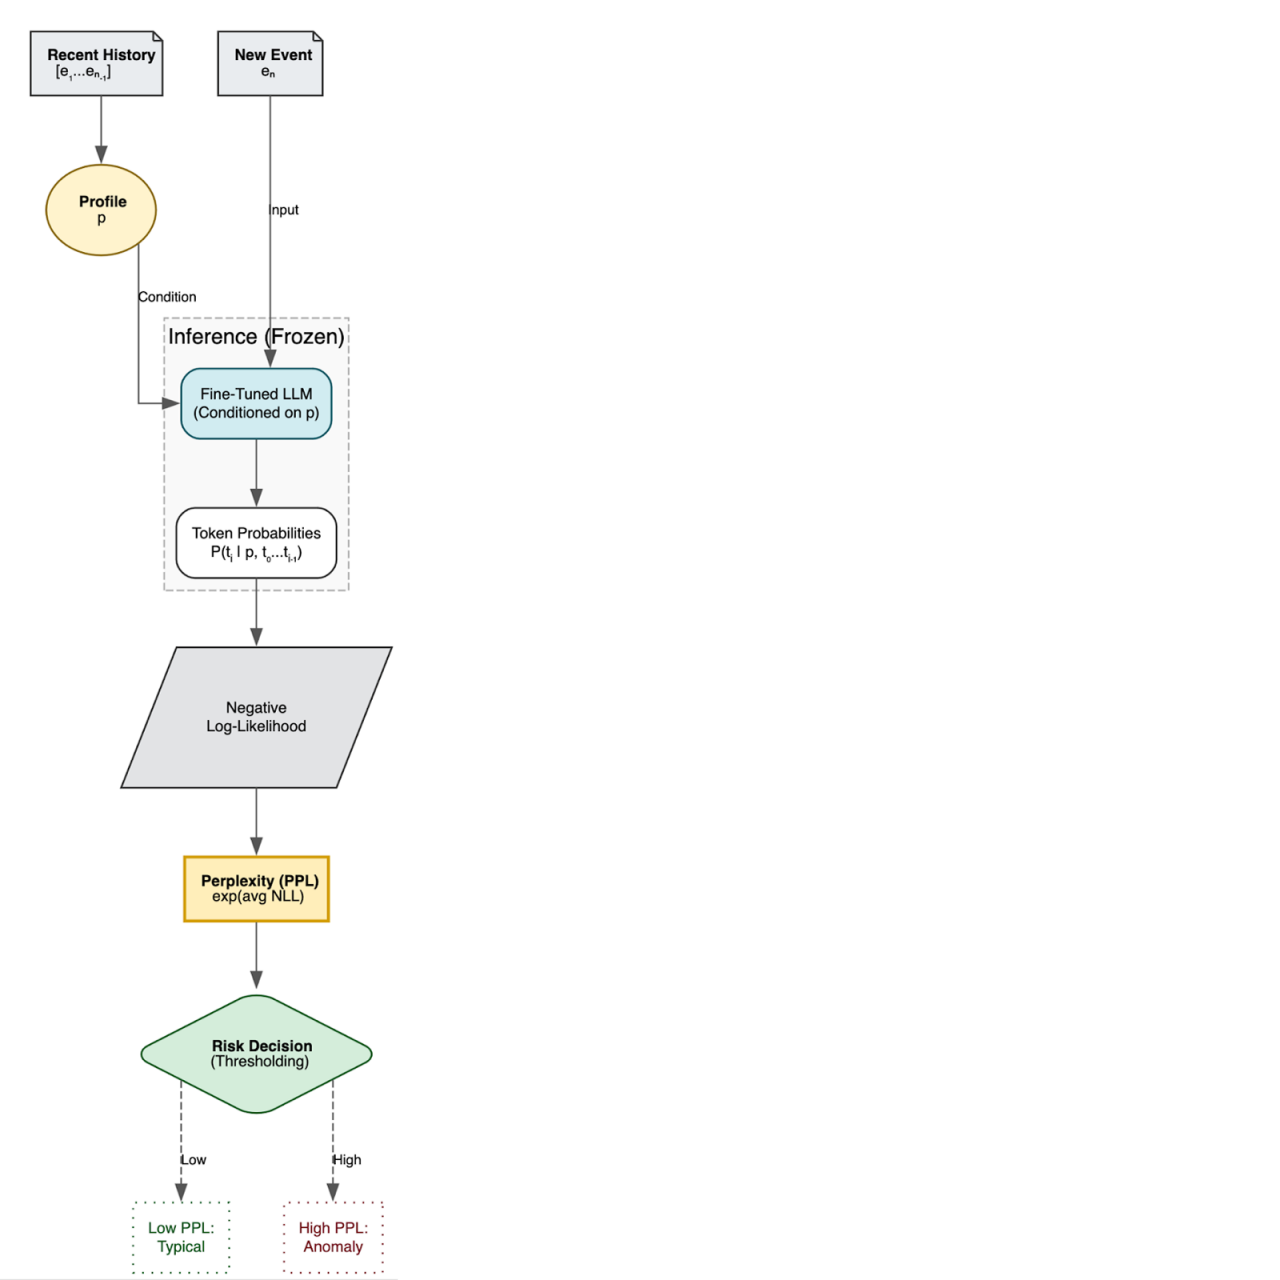
要約すると、まず新しく入ったるイベントについて次のことを実施します。
- アイデンティティの最近の履歴からプロファイル p を取得します。
- プロファイルとトークン化されたイベントをモデルに入力します。
- 「プロファイルと先行するトークンが与えられた場合、このイベントの各トークンがどれくらいの確率で発生するか」と質問します。
これにより、トークンごとの負の対数尤度(NLL)とパープレキシティが得られます。
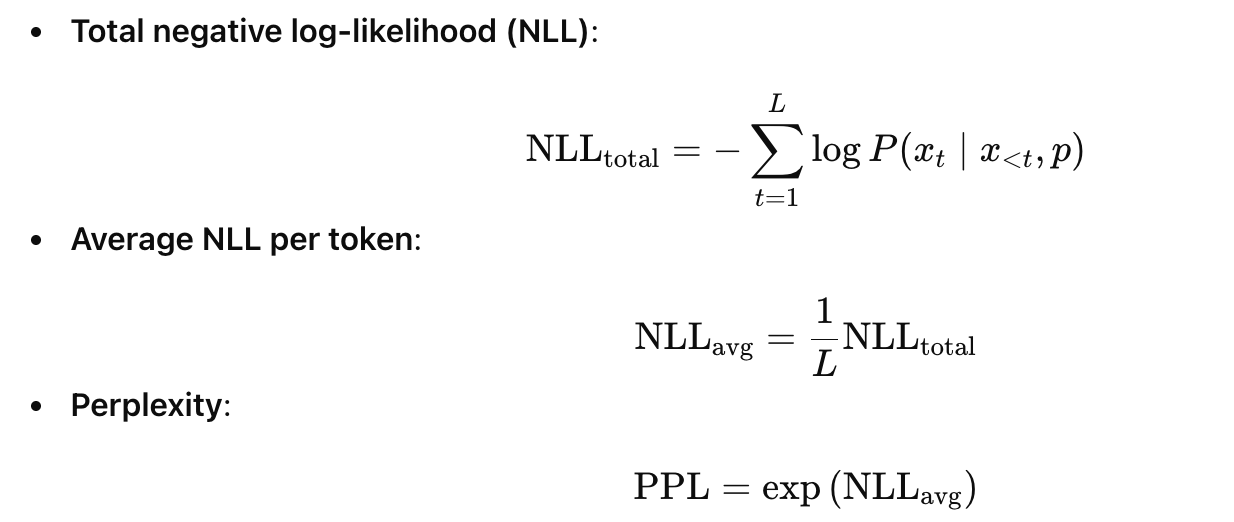
ただし、標準的なログ行には、重要な情報が埋もれてしまうような静的な「定型句」テキストが大量に含まれています。したがって、単純なグローバル平均の代わりに、ピークパープレキシティを計算します。ターゲットイベントで最も意外なトークン(つまり、NLL値が最も高いもの)上位K個を分離し、それらのトークンのみを平均化してから、指数化します。これにより、スコアが構造ではなく、情報(国名、ISP、デバイスなど)に焦点を当てるようになります。
運用上、リスクスコアはこのパープレキシティから算出されます。
- PPLが低い → リスクが低い: イベントはこのアイデンティティにとって非常に典型的に見えます。
- PPLが高い: → リスクが高い: イベントは、モデルがこのアイデンティティの履歴に基づき学習・推測したすべてのことを考慮すると、異常に見えます。
このモデルはアイデンティティごとのプロファイルに基づいて調整されるため、本質的にアダプティブとなります。
概念例
これが実際にどのように機能するかを説明するために、当社のモデルで処理されたシーケンスを見てみましょう。
このモデルは、イベント履歴を物語のように読み取ります。ユーザーの状況(場所、使用デバイス、および通常の認証方法)に基づいて、ユーザーの「プロファイル」を確立します。次に、ターゲットイベントを評価し、そのナラティブに合致するかどうかを確認します。
以下はユーザーセッションを簡略化したトレースです。モデルが焦点を当てている箇所を正確に示すため、高エントロピーノイズ(IDやハッシュなど)を取り除きました。ここでは簡略化されたバージョンを示します。
1. コンテキスト(プロファイル)
モデルはまずこれらのイベントを消費して、ユーザーの現在の状態を理解します。
[T-3] セッション開始xevent_type=user.session.start | country=United
[T-2] MFA検証event_type=user.authentication.verify |
country=United States | os=Windows 10 | device=Computer |
result=SUCCESS
[T-1] 内部認証event_type=security.internal.authentication |
country=United States | os=Windows 10 | device=Computer
2. 異常(ターゲットイベント)
ユーザーが突然管理アプリにアクセスしますが、コンテキストが大幅に変化しています。
[T-0] 管理者アクセスevent_type=user.session.access_admin_app |
country=India | city=Chennai | os=Android | device=Mobile
スコアの算出方法
モデルはターゲットイベントを処理する際、プロファイルに基づいて各トークンの確率を計算します。
「United States」および「Windows」という確立されたコンテキストに基づき、モデルはこうしたトークンが再び出現することを強く予測します。IndiaやAndroidに遭遇した場合、こうした単語の確率はほぼゼロまで低下します。このコンテキストの不一致により、関連するトークンの損失が大幅に急増、ピークパープレキシティスコアが異常としてフラグを立てるのに十分な高さに達します。
ピークパープレキシティを使用することで、LLMは意味的な矛盾を特定します。ユーザーがカンザスからチェンナイに瞬間的に移動し、その途中でデバイスを切り替えることは物理的に不可能です。
本書の内容
このLLMベースによるアイデンティティリスクのスコアリングはまだ実験段階ですが、具体的かつ数学的に根拠のある将来への道筋を示しています。
- 手作業で設計された機能ベクトルから、プロファイル条件付きシーケンスモデルに移行します。
- 場当たり的なルールウェイトではなく、NLLとパープレキシティを用いて、原則に基づいた異常スコアを取得します。
- この異常スコアを追加のシグナルとして、既存のパイプラインを置き換えることなく、既存のリスクパイプラインに統合できます。
今後の課題としては、プロファイル構築の改善、パープレキシティおよびリスクのマッピング調整、そしてイベントが予想外と判断された理由を自然言語で説明する機能拡張などが考えられます。


