



AIのラストマイル問題とは?
AIのラストマイルにおけるアイデンティティの問題は、入り口で確立されたアイデンティティのコンテキストが、実際に作業を行うシステムに到達する前に劣化することで発生します。その結果、リソースは、どのエージェントが、誰に代わって、どのような制約の下で動作しているかを示す検証可能なチェーンではなく、仮想キー、サービスアカウント、共有クライアントなどの認証情報に対して認可を行うことになります。最も重要な唯一の場所で最小権限を適用できなくなり、ダウンストリームのすべてのアクションが監査ログで同じように表示されます。
これまで、さまざまな業界のさまざまなチームと、これと似たような会話を何度もしてきましたが、いつも同じように始まります。銀行、保険会社、その他規制対象のエンタープライズでは、開発者はAIコーディングアシスタント(Claude CodeやCodexなど)の利用を望んでいます。そこでプラットフォームチームは、賢明かつ当然の措置として、すべてのリソースの前にAIゲートウェイを設置します。このゲートウェイは、モデルへのルーティング、予算とレート制限の適用、Model Context Protocol(MCP)を介した内部ツールへのアクセス仲介を行う場所を提供します。この考え方の背景にある意図は理解できますが、これはAIエージェントにおける「サービスアカウントモデル」と同等であり、実際の運用では厄介な問題が生じがちだと感じざるを得ません。
基本的に、ゲートウェイはキーを認証します。これでは人を認証できず、リクエストが社内ツールやデータソースなどの実際のリソースに到達する頃には、ダウンストリームでは誰もその違いを識別できなくなります。ゲートウェイの構成を厳格化しても、この問題は解決しません。つまり、その基盤に本物のアイデンティティを据えるということです。エージェントは独自の認証情報を取得し、すべての呼び出しはその背後にいる人間のアイデンティティを伝達します。そして、リソース自体がその認証情報を、その特定の人物に付与された権限と照合します。同じエージェント、同じゲートウェイ、同じコードでも、実際に誰が問い合わせているかに基づいて、異なる応答が返されるようになります。
AIゲートウェイがダウンストリームのアイデンティティ適用に失敗する理由とは?
現在、こうしたゲートウェイのほとんどは、エージェント(コーディングアシスタント)がキーを保持する仕組みになっています。エージェントはその仮想キーを使用してゲートウェイで認証を行います。その後、ゲートウェイはリクエストをモデルまたはMCPサーバーにルーティングします。
問題は、その連鎖の一番最後に表面化します。リクエストがゲートウェイを通過すると、その先にあるリソースは、リクエストの背後にいるのが誰なのかを実際に知る方法がありません。鍵しか認識しません。人間ではありません。特定の単一エージェントであるとは限りません。その日にアクセス権を持つ人なら誰でも使用できた単なる認証情報です。
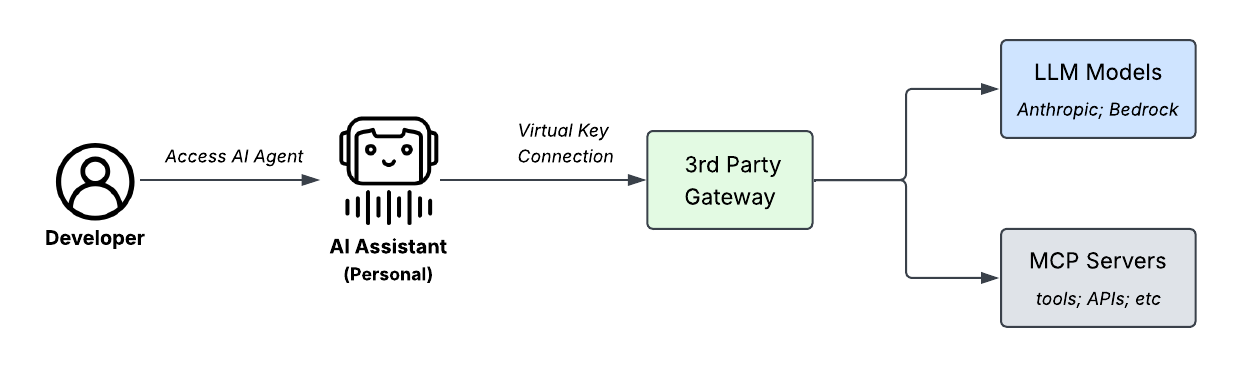 ほとんどのチームが最初に採用するパターンは、開発者、仮想キーを持つパーソナルAIアシスタント、ゲートウェイ、そしてそのダウンストリームにあるすべての要素で構成されます。このチェーンでは、開発者のアイデンティティがゲートウェイを通過することはありません。
フォーラムでは、この問題に対していくつかの呼び名が見られますが、私は「ラストマイル問題」という表現を使っています。ゲートウェイは、その目的のほとんどを達成します。つまり、何か(仮想キーなど)を認証し、最終的には適切なリソースにルーティングします。アイデンティティ、エンタイトルメント、認可に関する情報は一切含まれません。リクエストがMCPサーバーまたはモデルに到達する時点では、通常、システムはリクエストを実行しているアイデンティティに関する情報を何も把握していません。
キーベースのAIゲートウェイにおける中核的なセキュリティの脆弱性
- アイデンティティとしての静的クレデンシャル:静的なキーは、リクエストの送信元を動的かつ即座に失効可能に証明するアサーションではなく、単なるアイデンティティの代替として機能します(サービスアカウントモデルに類似)。
- 過剰な権限のデフォルト設定:アクセスは通常、誰かが意図的にアクセスを遮断するまで、デフォルトでオープンになっています。
- ポリシー統制の限界:ゲートウェイが「このキーがこのツールを呼び出した」というログを記録したとしても、処理系内の誰も「この人物が該当データへのアクセス権を保有しているか」を検証しないため、リソース側でアクセス制御を効かせることができません。
これは監査で明らかになります。AIを積極的に活用するチームに、誰が、どのような理由で、レコードやMCPサーバーにアクセスしたかを尋ねても、返ってくるのは沈黙でしょう。
アクセス統制ポイントとしてのゲートウェイの欠陥
これは、ゲートウェイにルールを追加で書き込むことで解消できるような構成上のギャップではないと考えます。真の意思決定を行うには、その判断の瞬間に次の3点が必要です。
- エージェントができること
- その特定の人間ユーザーに付与されている権限
- リソースのポリシーで許可されていること
設計上、ゲートウェイはそれらの最初の要素しか把握できず、多くの場合それすらも難しく、単に「誰かが有効なキーを提示した」ということしか分かりません。
アイデンティティプロバイダーを「後付け」しても失敗するのはなぜでしょうか?
次に一般的なステップとして、アイデンティティプロバイダー(IdP)を追加し、代理(on-behalf-of)でのトークン交換を実行します(これがサポートされている場合)。これにより、エージェントは独自の静的キーを保持するのではなく、ユーザーのアクセストークンを継承します。
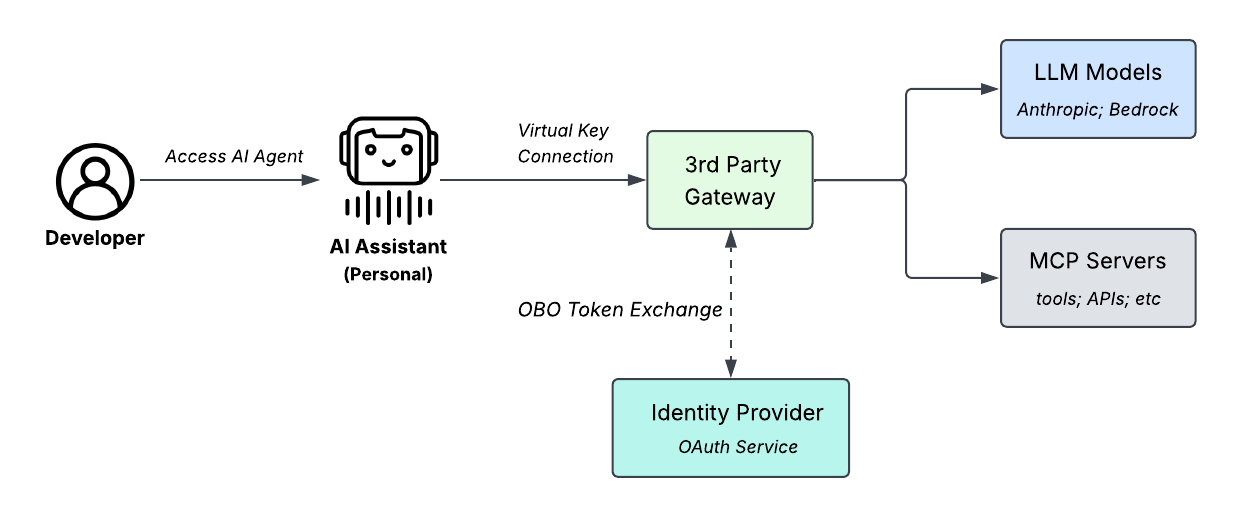 次のステップは、後付けのIdPです。
このパターンは、少なくともどの人間がログインしたかがわかるようになるため、正しい方向への一歩と言えます。しかし、結局は同じラストマイルの問題に突き当たります。階層が1つ下がるだけで、「このリクエストを呼び出したのはどのエージェントか」という問題に直面するのです。リソースには、エージェントXがユーザーYの代理として正当に機能していることを検証する方法がなく、それを停止させるためのキルスイッチもありません。人間を介在させる(Human-in-the-loop)プロセスが存在せず、その特定のエージェントを個別ブロックする方法も、アクセス権を失効させる方法もありません。そのフローにおいて、エージェントは依然として独立したアイデンティティ(第一級の主体)として扱われておらず、ユーザーのアイデンティティをそのまま借用しているにすぎません。セキュリティ分野で知られる「Confused Deputy(代理の混乱)」問題のインシデントをご存知であれば、これが解決策ではなく、むしろ重大なリスクであることがお分かりいただけるはずです。
では、どのような修正が考えられるでしょうか? ゲートウェイレベルでIdPを後付けしても、方向性がわかるだけで、どのユーザーがどのエージェントにどのアクションを依頼したかを知るという最終的な目標は達成できないことは、すでに述べたとおりです。
エージェント対応アイデンティティガバナンスのソリューションとは
その答えは、AIエージェントをアイデンティティおよびアクセス管理フレームワーク内で第一級のアイデンティティとして扱い、ユーザーとエージェントの認可チェックをリソースレベルではなくリクエストレベルで結び付けることにあります。Oktaでは、下図に示すようにOkta for AI Agentsでこの機能を提供します。
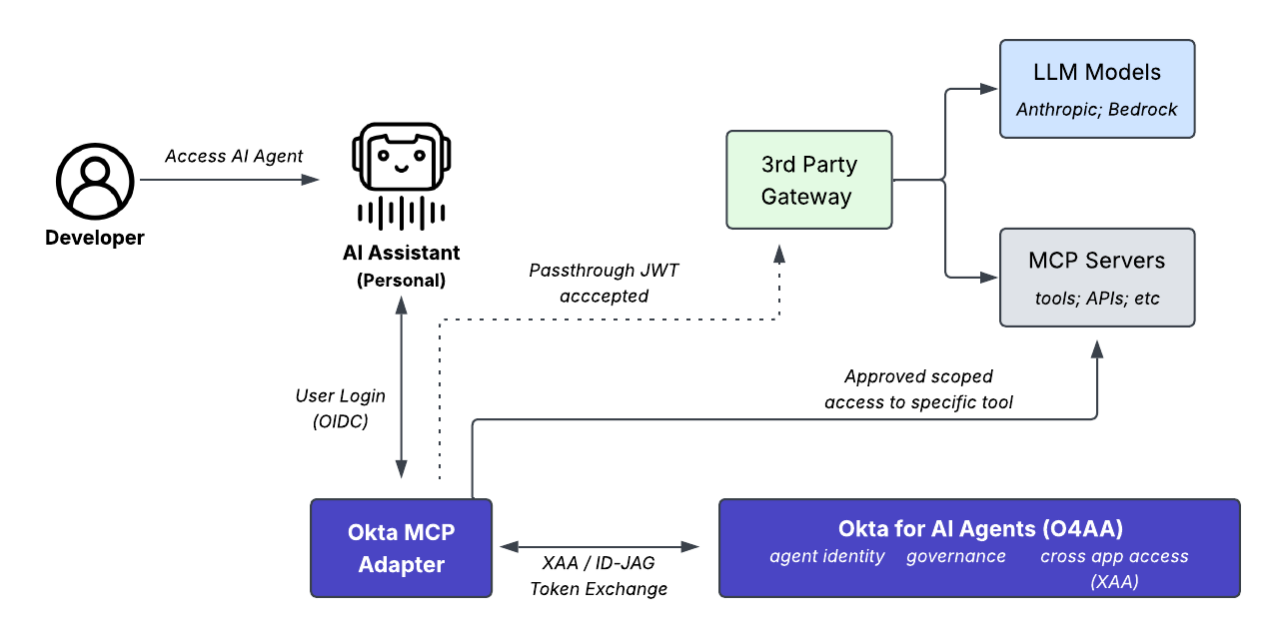 解決策:アシスタントは、独自のガバナンスの効いたアイデンティティを取得します。ユーザーが一度ログインすると、アダプターがアイデンティティレイヤーに対してトークン交換を実行し、承認され、スコープが限定されたトークンのみが実際のツールに到達します。
この設定により、ユーザーはリクエストの前に認証できます。さらに重要なのは、ユーザーレベルの認可(アクセス可能な範囲の上限を設定するもの)を、そのエージェントを介して行う各リクエストに紐付けられることです。もちろん、ユーザーは上限の範囲内で操作できますが、上限を超えることはできません。Cross App Access仕様で提供されるこのモデルにより、AIエージェントの展開と運用で発生するラストマイルの問題を最終的に解決できます。
動的なリクエストレベルの認可の仕組み
認証:人間のユーザーがOpenID Connect(OIDC)を使用して認証します。
エンタイトルメントのスコープ:アイデンティティレイヤーは、トークンを発行する前に3つの異なるポリシーを評価します。
エージェントの認可:このエージェントは、このユーザーの代理として行動することを許可されていますか?
ターゲットの到達可能性:このエージェントは、この特定のリソースへのアクセスを許可されていますか?
ユーザーエンタイトルメントの上限:このユーザーがそのリソースに対して具体的に許可されている操作(読み取り/書き込み/アクセス)は何ですか?
トークンの発行:システムは、エージェントと人間の権限の明示的な共通部分を保持する、有効期間が短く単一使用にバインドされたベアラートークンを生成します。
この共通部分(論理積)の評価は単一の場所で行われるわけではありません。下の図に示すように、2つの認可ポイントで、人間とエージェントがアクセスできる対象を定めた実際のポリシーを評価します。AIエージェントによる最初のツールコールは、Okta MCP Bridge Adapterに送られます。このアダプタは、いくつかのインタラクションを担います。まず、標準のOpenID Connect(OIDC)パターンを通じて、ユーザーのログインを仲介します。次に、Okta Orgの認可サーバー(エージェントのエンタイトルメントを評価し、ID-JAGトークンを発行)とリソースの認可サーバーとの間でCross-App Accessのハンドシェイクを調整し、バインドされたベアラートークン(エージェントと人間の両方のエンタイトルメントを含む)を発行します。人とエージェント両方のチェック結果を含むトークンのみがMCPサーバーに到達します。
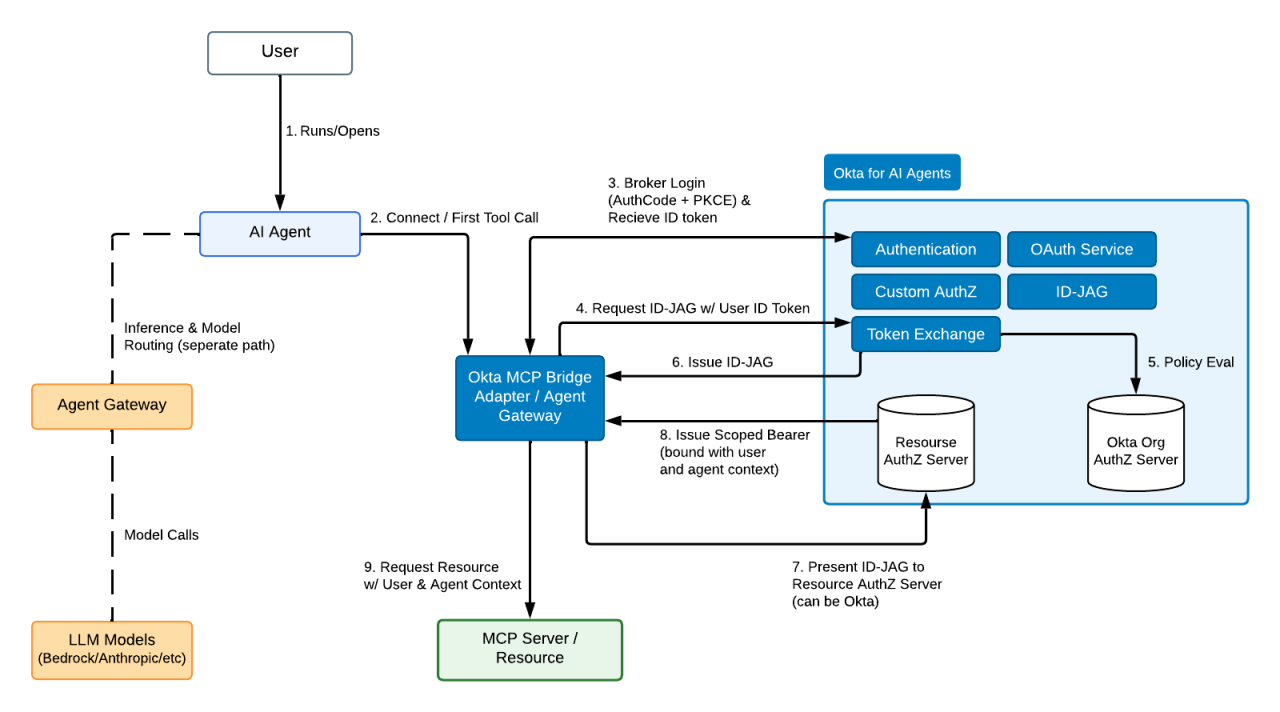 Okta for AI AgentsによるCross App Accessの仕組み。人間が一度認証すると、エージェントはその人間に紐付けられた、有効期間が短く一度しか使えないアサーションを要求します。その後、個別の認可サーバーがポリシーに照らしてアサーションを評価し、リソースが実際に信頼できる、スコープが限定されたベアラートークンを発行します。
アイデンティティレイヤーは、リクエストがリソースに到達する前にその共通部分を計算し、すでに判定結果が含まれているトークンを返します。際には、次の3つの問いについて検証する必要があります。第一に、このエージェントはこのユーザーの代理として行動することを許可されているか?第二に、このエージェントはこのリソースへのアクセスを許可されているか?最後に、リソースに到達した後、実際に何ができるか(1件のレコードの読み取り、すべてのレコードの読み取り、あるいはレコードへの書き込みか)?
このモデルでは、2つの個別の認可サーバーが次の質問をしています。Okta Orgの認可サーバーは、「このエージェントは、このユーザーに代わって動作し、このリソースにアクセスすることが許可されているか」というエージェントに関する問いに答えます。リソース独自の認可サーバー(Oktaまたはリソース独自のサーバー)は、「この人物が実際に誰であるかを踏まえた上で、現時点でどのような権限が付与されているか」という人間に関する問いに答えます。ちらのチェックも単独では権限の共通部分(論理積)を形成しません。この共通部分(両方の権限が合致する範囲)こそが、双方の検証プロセスを経て最終的に生成される、スコープ限定ベアラートークンの実体です。リソースは、ツールを呼び出すたびにこれらのチェックを再実装する必要はありません。トークンを検証し、スコープをチェックするだけです。
AIゲートウェイと統制されたエージェントアイデンティティの機能比較
| セキュリティと運用能力 | スタンドアロンAIゲートウェイ | AIゲートウェイ + 管理されたエージェントアイデンティティ |
|---|---|---|
| モデルルーティング、コスト管理、レート制限 | はい、それが中核となる強みです | はい、変更なし |
| ツールとデータソースのスコープ | キーごと、またはチームごと(ユーザーコンテキストなし) | ユーザーごとに一元管理 |
| ガバナンス統制された第一級のエージェントアイデンティティ | いいえ、アイデンティティは静的なキーです。 | はい、登録され、所有されたアイデンティティです |
| 検証可能な委任(特定ユーザーの代理として機能するエージェント) | いいえ、リクエストにはアクターではなくキーが含まれています。 | はい、すべての呼び出しには、それを承認した人物の情報が含まれます。 |
| 認証情報のライフサイクル | 有効期間の長い共有キー | 有効期間が短く、エージェントごとに発行されるトークン |
| デフォルトのアクセススタンス | 誰かが別途設定するまで、デフォルトでオープンな状態になります | デフォルトで拒否(最小権限) |
| エージェントライフサイクルガバナンス | 自社開発 | 他のアイデンティティと同様に管理 |
ゲートウェイはコスト制御やルーティングの強力な窓口(フロントドア)ですが、文字通り「アイデンティティ(識別情報)の危機」に直面していることは否定できません。「誰が何にアクセスできるか」の判定権限は1つ下のレイヤーに属しており、ゲートウェイで打ち切られることなく、リクエストと共にリソースまで伝達される必要があります。
実例:エンタイトルメント上限を強制適用する
給与情報を検索できる社内ボットがあるとします。この同じボットと3人の異なる人物が対話します。1人目は一般従業員のCharlieで、自分の給与しか閲覧できません。2人目はコンプライアンス担当者で、全員の給与を閲覧できますが、変更はできません。3人目はCFOで、全員の給与を閲覧し、更新できます。同じボットに対し、同じようなアクションですが、関わる人によって上限が異なります。
Charlieはゲートウェイを介してボットに「私の給与はいくらですか?」と尋ねます。ボットは正しい応答を返します。ここでは$ 70,000とします。問題はその後の質問から生じます。チャーリーが「アリスの給料は?」と入力すると、ボットは再びその答えを返します。
ユーザー、エージェント、AIゲートウェイ、MCPサーバーのいずれも、「チャーリーとして」と「このキーを保持する者として」の違いをチェックしませんでした。ゲートウェイはプラットフォームチームの設定どおりに動作しましたが、そのゲートウェイは違いを認識できないため、両者を区別するようには設定されていませんでした。
では、同じゲートウェイの下にアイデンティティレイヤーを配置してみましょう。Charlieは本人として認証を行います。これにより、すべての呼び出しにおける実行権限は「エージェントが要求できる範囲」「Charlie個人に付与された権限」「リソースのアクセスポリシーによる許可」という3つの条件の共通部分(論理積)で評価されます。
Charlieが自身の給与情報を要求した場合、3つの要件がすべて合致するため処理が許可されます。Aliceの情報を要求した場合、たとえエージェントやゲートウェイがそれを許可したとしても、3つの条件のうち2番目の要素(ユーザー本人の権限)を満たさないため、システムはリクエストを拒否します。ユーザーをCFOに切り替えて同じエージェントを使用した場合は、CFOが異なるエンタイトルメント上限を持っているためリクエストが許可されます。エンタイトルメント上限は、チーム全員で使い回せる共通キーに固着するものではなく、操作を行う人間(ユーザー)に紐付いて動的に伝達されます。
よくある質問(FAQ)
毎回、「うちのゲートウェイで既に対応しているのでは?」といった質問を受けます。
キーが識別するのは呼び出し元個人ではなく、あくまで呼び出し元のカテゴリ(種別)にすぎない点に注意が必要です。キーには、リソース側で検証したり人事異動の瞬間に即時失効させたりできるような、人間に紐付く動的なエンタイトルメント(権限)が含まれていません。同じキーを共有する2人のユーザーは、ダウンストリームの全システムから完全に同一人物として認識されてしまいます。
すべての情報交換はバックエンドで行われます。開発者は昨日と同じようにコーディングアシスタントと対話します。認証とトークンの交換は、ワークフローに影響を与えることなくバックグラウンドで実行されます。開発者の日々の業務の進め方を変えてしまうようなものは、作り方が間違っています。
これについてはお勧めしません。事実上、各ツールを所有するチームが、そのツールのためだけのガバナンスを自前で構築し、永続的に運用することになります。監査や取り消しを行うための一元的かつ永続的に管理された単一のアイデンティティを提供できません。その結果、同じチェックに対して手作業で作成された微妙に異なるバージョンが複数存在することになり、それらの間で共有される信頼できる情報源もなくなります。
AIゲートウェイをアイデンティティレイヤーに置き換えるべきでしょうか?
ここでの議論は、「ゲートウェイを撤去せよ」ということではありません。エージェントゲートウェイは、ルーティング、コスト管理、レート制限、ツールのディスカバリーなど、その設計目的に応じてITランドスケープで役割を果たします。特定のユーザーコンテキストを伝達するようには設計されていませんでした。それは別のレイヤーであり、横に位置して、個々のリクエストをそれぞれ独自の条件で評価します。
では、これまでに構築したものをすべて破棄する必要があるのでしょうか?いいえ、その必要はありません。これは、ゲートウェイとアイデンティティレイヤーがそれぞれ異なる役割を担っているにもかかわらず、今日のほとんどのアーキテクチャでは、その一方にしかコストをかけていないことを意味します。
AIアイデンティティアーキテクチャを管理する
ラストマイル問題を解決するには、ゲートウェイと並行して機能し、すべてのリクエストを独自の条件で評価する専用のアイデンティティレイヤーが必要です。
Okta for AI Agentsを導入することで、常時有効な静的キーに頼るのではなく、人間のユーザーに紐付くリクエスト単位の認可上限を設定できます。Oktaは、開発者にとっての余計な手間や負担を生じさせることなく従業員や開発者のワークフローを保護し、AIの自律運用機能を安心して拡張できるよう支援します。
ゲートウェイのアイデンティティクライシスを解消しませんか?
セキュアなエージェント型エンタープライズの設計図をダウンロードして、貴社のエージェントセキュリティアーキテクチャを評価し、エンタープライズAIエージェントをファーストクラスのアイデンティティとして扱うことで、Oktaがどのようにその管理を支援できるかをご確認ください。


