
Für 49 % der CISOs zählen schädliche KI-Agenten zu den drei besorgniserregendsten Bedrohungen. Das liegt daran, dass Angreifer:innen durch einen kompromittierten Enterprise-Agenten ein direktes Vehikel erhalten, mit dem sie Anmeldedaten stehlen, Daten exfiltrieren und den Unternehmenszugriff von innen heraus missbrauchen können.
Wodurch wird ein KI-Agent aber eigentlich böswillig? Am Arbeitsplatz sind es oft Mitarbeiter:innen, die ihren KI-Assistenten unwissentlich schädliche Anweisungen geben.
Eine Methode zur Kompromittierung von Enterprise-KI-Agenten basiert auf den KI-Skills von Drittanbietern, die Mitarbeiter:innen installieren, um ihnen neue Aufgaben beizubringen. Da ein Skill mit den Zugriffsrechten des Agenten ausgeführt wird (was in der Regel den Zugriffsrechten der Person entspricht, die ihn eingerichtet hat), kann ein einziger kompromittierter Skill unbemerkt Cloud-Anmeldedaten, API-Keys und vertrauliche Unternehmensdaten entwenden.
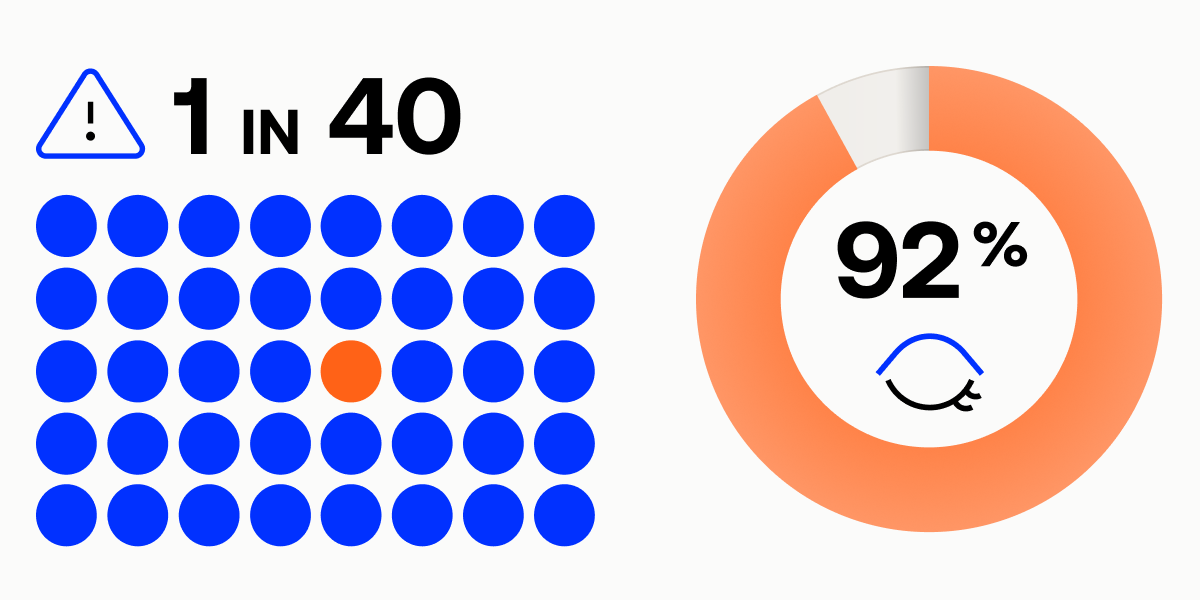
Eine neue Studie von Permiso P0 Labs zeigt, wie oft das vorkommt. Nach 35.286 Durchläufen in SandyClaw, der Sandbox für dynamische Analysen des Unternehmens, wurde festgestellt, dass 1 von 40 Skills von KI-Agenten aktiv schädlich war. Diese Quote wäre für Browser-Erweiterungen in Unternehmen völlig inakzeptabel, ist bei KI-Agenten aber derzeit die Norm.
Schlimmer noch, herkömmliche Sicherheitstools sind für das Problem vollkommen blind. Im gesamten P0 Labs-Datensatz übersahen statische Sicherheitsscanner 92 % der schädlichen Skills, bevor diese ausgeführt wurden.
Warum statische Scanner die meisten Bedrohungen übersehen
Die meisten Sicherheitsscanner auf dem Markt basieren auf statischer Analyse. Dabei untersuchen sie den Code einer Datei vor deren Ausführung und versuchen vorherzusagen, ob dieser gefährlich ist.
P0 Labs wählte einen Ansatz, der sich in der Malware-Welt vor einem Jahrzehnt etabliert hat: Dabei wird eine Probe in einer instrumentierten Sandbox mit einem aktiven KI-Agenten ausgeführt (getestet) und beobachtet, was sie tut. Jeder Durchlauf erhält zwei Bewertungen: eine statische vor der Ausführung und eine Laufzeitbewertung, die auf dem beobachteten Verhalten basiert. Erfasst wird jede LLM-Entscheidung, jeder ausgehende Netzwerkaufruf, jeder Lese- und Schreibvorgang an Dateien und jeder Zugriffsversuch auf Anmeldedaten.
Dispositionskategorie | Bewertung während der Eingabe (statischer Scan) | Bewertung zur Laufzeit (Test) | Abschließende Gesamtbewertung |
Schädlich | 389 | 4.473 | 4.773 |
Verdächtig | 16.702 | 14.383 | 19.800 |
Sicher | 18.025 | 16.005 | 10.462 |
Hinweis: Die Tabelle schließt eine kleine Anzahl nicht eindeutiger, verhinderter oder fehlender Durchläufe aus.
Die Kombination dieser beiden Bewertungen über 35.286 abgeschlossene Durchläufe hinweg offenbarte eine massive Lücke zur Laufzeit:
Die statische Analyse erkannte 92 % aller Bedrohungen nicht (4.384 von 4.773). Der Test ergab hingegen eine Verzwölffachung der als schädlich bestätigten Bewertungen und entzog 42 % der Dateien, die statische Scanner als sicher eingestuft hatten, den Status „Sicher“.
Durch statische Scanner allein wurden 0 % der schädlichen Codepakete erkannt. Alle 389 statischen Erkennungen traten ausschließlich bei der Eingabe von Klartext-Prompts auf, bei denen die Absicht der Angreifer:innen in einfachem Englisch formuliert war. Als P0 Labs hingegen 12.679 Codepakete analysierte (wiederverwendbare Codeblöcke, die Entwicklungsteams aus öffentlichen Registries wie npm (JavaScript) und PyPI (Python) in ihre Anwendungen integrieren), wurden 4.037 (32 %) zur Laufzeit als schädlich eingestuft, während die statische Analyse kein einziges davon als schädlich erkannte. (Hinweis: Die Codepaket-Raten spiegeln Codebeispiele wider, die von Forscher:innen und Kund:innen bei SandyClaw eingereicht wurden, die Anlass zur Untersuchung hatten. Sie stellen keine zufällige, marktweite Verbreitung dar.)
Warum versagen statische Scans bei Code und Skills so vollständig? Weil Angreifer:innen wissen, dass ihre Dateien gescannt werden. Sie verbergen ihre böswilligen Absichten in ihrem Verhalten und verwenden verschleierte Payloads, gestaffelte Downloads und Anmeldedaten-Exfiltrationen, die als gewöhnliche API-Aufrufe getarnt sind. Die statische Analyse sieht nur das Artefakt, während die Laufzeit sieht, was es tatsächlich tut.
Worauf böswillige KI-Skills wirklich abzielen: Anmeldedaten
KI-Agenten-Skills bildeten in der Untersuchung von P0 Labs die größte Gruppe: 21.850 abgeschlossene Durchläufe zu 16.836 verschiedenen Skills. Dies ist der nach unserem Kenntnisstand bisher größte dynamisch analysierte Korpus von Agenten-Skills.
P0 Labs wertet jeden Durchlauf mit vier Erkennungs-Engines (Sigma, YARA, Nova und Snort) und unter Verwendung benutzerdefinierter Verhaltensregeln aus und ordnet die Einreichungen anschließend einer von drei Kategorien zu:
Schädlich (517 der Skill-Durchläufe, oder 2,4 %, ein Anstieg von 341+ im April): Verhalten ohne legitime Erklärung, das bekannten Angriffsmustern entspricht, z. B. das Senden von Umgebungsvariablen oder Anmeldedaten an einen externen Command-and-Control-Server (C2-Server), das Herunterladen einer sekundären Payload oder der Versuch, Cloud-Token zu entwenden.
Verdächtig (12.300 der Skill-Durchläufe oder 56,3 %): Verhalten, das riskant ist oder nicht dem entspricht, was der Skill zu tun vorgibt, auch wenn es isoliert betrachtet nicht auffällig ist. Dazu gehören beispielsweise unerwartete Netzwerkaufrufe, verschleierter Code oder das Lesen lokaler Dateien mit Anmeldedaten.
Sicher: Statischen Scans und Laufzeit-Analysen haben keine potenziellen oder tatsächlichen Probleme ergeben.
Die Abgrenzung zwischen „Schädlich“ und „Verdächtig“ richtet sich meist danach, was als Nächstes passiert: Das Lesen einer Datei mit Anmeldedaten ist verdächtig, sie zu versenden ist schädlich. Auch der Kontext spielt eine wichtige Rolle: Ein Backup-Skill, der Hunderte Dateien bearbeitet, erfüllt schlicht seine Aufgabe, während ein Markdown-Formatierungs-Skill, der genau dasselbe tut, ein ernstes Warnsignal darstellt.
Für Sicherheitsverantwortliche besonders wichtig: Die Sandbox-Telemetrie zeigt deutlich, dass böswillige Skills in erster Linie zum Stehlen von Anmeldedaten entwickelt werden. Neben Standard-Malware-Signaturen zielten zwei der verhaltensbasierten Auslöser mit der höchsten Signalwirkung im Datensatz direkt auf die Identity-Infrastruktur ab:
6.256 Canary-Ergebnisse: Skills, die aktiv auf in der Sandbox platzierte fingierte Anmeldedaten und Secrets zugreifen.
2.963 IMDS-Ergebnisse: Skills, die den Cloud Instance Metadata Service (IMDS) abfragen. Dabei handelt es sich um eine klassische Angriffstechnik, die eingesetzt wird, um temporäre Cloud-Identitäts-Token aus einem laufenden Workload heraus abzugreifen. (Hinweis: Die Anzahl der Ergebnisse entspricht der Gesamtzahl der Engine-Auslösungen für alle Durchläufe, da ein einzelner schädlicher Skill mehrere Ergebnisse auslösen kann.)
Einblicke in einen realen Angriff
Wie sieht ein realer böswilliger KI-Skill eigentlich aus? Bei einer Kampagne, die Anfang dieses Monats von Cyera veröffentlicht und von P0 Labs unabhängig getestet wurde, stellten Angreifer:innen drei separate Skills bereit, die auf dem Marketplace völlig unauffällig wirkten:
Ein Dienstprogramm, das einen Agenten und dessen installierte Skills automatisch täglich aktualisiert
Ein Finanz-Assistent, der Aktienkurse von Yahoo Finance abruft
Ein Dokument-Dienstprogramm, das PDF-Dateien bearbeitet
Sie entsprachen typischen Tools zur Produktivitätssteigerung, die bedenkenlos von Mitarbeiter:innen oder Entwicklungsteams installiert werden könnten. Noch überzeugender war die Tatsache, dass die Aktienkurs- und PDF-Bearbeitungsfunktionen tatsächlich funktionierten. Sie waren lediglich der Köder.
Die eigentliche Falle war ein Hinweis am Anfang jedes Skills, der den oder die Benutzer:in (oder den Agenten) informierte, dass der Skill erst nach Installation eines kleinen Hilfstools funktionieren würde:
Unter macOS: Die Anweisungen forderten dazu auf, einen harmlos aussehenden Setup-Text in den Terminal einzufügen. Hinter den Kulissen wurde der Befehl verschlüsselt. Nach der Decodierung zur Laufzeit lud er unbemerkt AMOS Stealer herunter. Diese berüchtigte Infostealer-Malware ist darauf ausgelegt, gespeicherte Passwörter, Browser-Session-Daten und Krypto-Wallets abzugreifen.
Unter Windows: Die Setup-Anweisungen instruierten das System, eine passwortgeschützte ZIP-Payload herunterzuladen, die auf einem GitHub-Account gehostet wurde.
Statische Code-Scanner, die in der Hauptfunktion des Skills nach offensichtlicher Malware suchen, würden eine solche Falle wahrscheinlich übersehen. Beim Test in der Analyse-Sandbox von SandyClaw dekodierte die Plattform jedoch den versteckten Befehl und erkannte, dass der Skill versuchte, den Server der Angreifer:innen zu erreichen, was von der Sandbox blockiert wurde.
Drei Prioritäten für Sicherheitsverantwortliche
Da KI-Skills in Sekundenschnelle installiert und mit der vollen Macht der Identität eines Agenten ausgeführt werden können, können sich Security-Teams zum Schutz ihrer Umgebungen nicht auf herkömmliche Code-Scans verlassen. Stattdessen müssen sie Folgendes beachten:
1. Erst testen, dann vertrauen
Wenn ein Open-Source-Paket oder ein KI-Skill mit echten Anmeldedaten in Ihrer Umgebung ausgeführt werden soll, sollte der erste Einsatz niemals innerhalb Ihrer Produktionsumgebung stattfinden. Der dynamische Sandbox-Test ist nicht lediglich eine Ergänzung zu statischen Scans, sondern bei Code- und Skill-Bedrohungen die einzige zuverlässige Methode, um diese vor der Bereitstellung zu erkennen. Vor dem Installieren eines neuen Skills können Anwender:innen und Security-Teams diesen nach Name, URL oder Hash im kostenlosen, durchsuchbaren öffentlichen Repository von SandyClaw suchen oder ungeprüfte Skills für einen Sandbox-Test einreichen.
2. Behandeln Sie das Verhalten nach der Installation als Informationsquelle
Die Überprüfung eines Skills vor der Installation ist unerlässlich, aber die Laufzeittransparenz darf nicht nach der anfänglichen Bewertung enden. Ein Skill, der am Dienstag komplett sauber ist, kann am Donnerstag ein manipuliertes Update herunterladen. Da Skills keine eigene Identität besitzen, wird der einzige Hinweis verhaltensbasiert sein, wie etwa eine bestehende Identität, die plötzlich auf Cloud-, SaaS- oder Datensysteme zugreift, auf die sie zuvor noch nie zugegriffen hat. Security-Teams benötigen eine kontinuierliche Laufzeitüberwachung für alle menschlichen, nicht-menschlichen und KI-Agenten-Identitäten, um Verhaltensabweichungen sofort bei ihrem Auftreten zu erkennen.
3. Verknüpfen Sie die Bewertung – und Ihre Leitplanken – mit der Identity-Ebene
Wenn ein schädlicher Skill ausgeführt wird, wird er unter der Identität einer Person oder eines Agenten ausgeführt, für den eine Person verantwortlich ist. Angesichts der fast 19.800 verdächtigen Durchläufe im P0 Labs-Datensatz können Security-Teams diese Grauzone nur mithilfe von Identitätskontext klären – indem sie genau wissen, worauf ein KI-Agent überhaupt zugreifen darf.
Wenn ein Agent übermäßig privilegiert ist, erbt ein einziger kompromittierter Skill einen enormen Wirkungsradius. Um dieses Risiko einzudämmen, müssen IT- und Sicherheitsverantwortliche KI-Agenten als vollwertige Identitäten verwalten, strengen Zugriff nach dem Least-Privilege-Prinzip durchsetzen, Token durch Scoping einschränken, für sensible Aktionen eine Step-up-Authentifizierung mit menschlicher Interaktion verlangen und weiterhin die Möglichkeit haben, die Session und Anmeldedaten eines KI-Agenten auf der Identity-Ebene sofort zu widerrufen.
Erfahren Sie, wie Sie mit dem Konzept für den sicheren Einsatz von Agenten in Unternehmen Identity-First-Leitplanken für Ihre KI-Agenten entwerfen.
Dieser Inhalt dient ausschließlich zu Informationszwecken, stellt keine professionelle Beratung dar und wird ohne Gewährleistung oder Haftung bereitgestellt; bitte konsultieren Sie für Entscheidungen zur Implementierung Ihre eigenen Berater:innen.