



Eine Frage landet derzeit sehr häufig in den Posteingängen von CISOs und CIOs:
„Was KI-Agenten können, ist wirklich beeindruckend. Aber wie viele Identity-Administrator:innen muss ich eigentlich einstellen, um sie alle zu verwalten?“
Das ist eine durchaus berechtigte Frage. Doch streng genommen geht sie am Kern des Problems vorbei, denn Unternehmen, die die Governance von KI-Agenten als Personalproblem betrachten, werden zwangsläufig scheitern. Und zwar nicht, weil sie nicht schnell genug neues Personal einstellen können, sondern weil noch so viele menschliche Administrator:innen das grundlegende strukturelle Problem nicht lösen können.
Die zentrale Frage ist nicht, wie viele Mitarbeitende Sie für die Verwaltung von KI-Agenten benötigen, sondern welche Voraussetzungen Sie schaffen müssen, um auch bei einer Flotte von Tausenden oder mehr KI-Agenten den Überblick zu behalten. Das Fundament dafür ist Identity-Management, und genau jetzt ist der richtige Zeitpunkt, um die dafür nötigen Strukturen dafür zu schaffen.
Warum sich das Identity-Problem bei KI-Agenten von allen bisherigen IAM-Problemen unterscheidet
KI-Agenten stellen alle Annahmen und Regeln in Frage, mit denen herkömmliche IAM-Prozesse (Identity and Access Management) entwickelt wurden. Dazu gehören beispielsweise folgende:
- Identity-Management ist an die Größe unserer Belegschaft bzw. Kundschaft gebunden. Bisher nahm der Aufwand für das Management menschlicher Identitäten mit der Zahl der Mitarbeitenden bzw. Kundinnen und Kunden zu. Der Verwaltungsaufwand für die Identitäten von KI-Agenten wächst dagegen mit der Zahl der Bereitstellungs-Pipelines. Ein einziges Mitglied des Entwicklungsteams ist in der Lage, vor der Mittagspause Hunderte Agenten bereitzustellen. Auf diese Masse und Geschwindigkeit sind weder die Provisionierungsprozesse Ihres Unternehmens noch ein Team von Identity-Administrator:innen ausgelegt, das mit einem Ticketsystem arbeitet.
- Die Identitäten sind bekannt, bevor sie benötigt werden. Bei herkömmlichen Provisionierungsprozessen wird davon ausgegangen, dass zunächst eine Anfrage gestellt und daraufhin eine Identität erstellt und Zugriff gewährt wird. Bei Agenten kann es jedoch vorkommen, dass sie bereits im Produktivbetrieb laufen, bevor das Security-Team überhaupt von ihrer Existenz weiß. Fehlende Transparenz, die es von vornherein gar nicht gab, kann deshalb nicht einfach durch mehr Personal ausgeglichen werden.
- Die Akteure handeln vorhersehbar. Ein Service-Account ruft immer die gleichen drei APIs in derselben Reihenfolge auf. Ein Agent dagegen trifft auf Basis seiner Kontextinformationen und Anweisungen autonome Entscheidungen darüber, worauf er zugreift. Die Angriffsfläche beschränkt sich somit nicht mehr nur auf die Anmeldedaten einer Identität, sondern umfasst auch die von ihr getroffenen Entscheidungen.
- Die Identity-Ketten sind flach. IAM wurde für ein Benutzer-zu-App- oder Benutzer-zu-System-Modell entwickelt, das einfach und flach ist. Mit Agenten gibt es hingegen gänzlich neue Modelle, z. B. Agent-zu-Agent, Agent-zu-Tool oder Agent-zu-Agent-zu-App. Dadurch entstehen komplexe Zugriffsgeflechte, bei denen Administrator:innen, die Provisionierungs-Tickets überprüfen, keine Möglichkeit haben, das Risiko von Ketten zu bewerten, die sie gar nicht einsehen können.
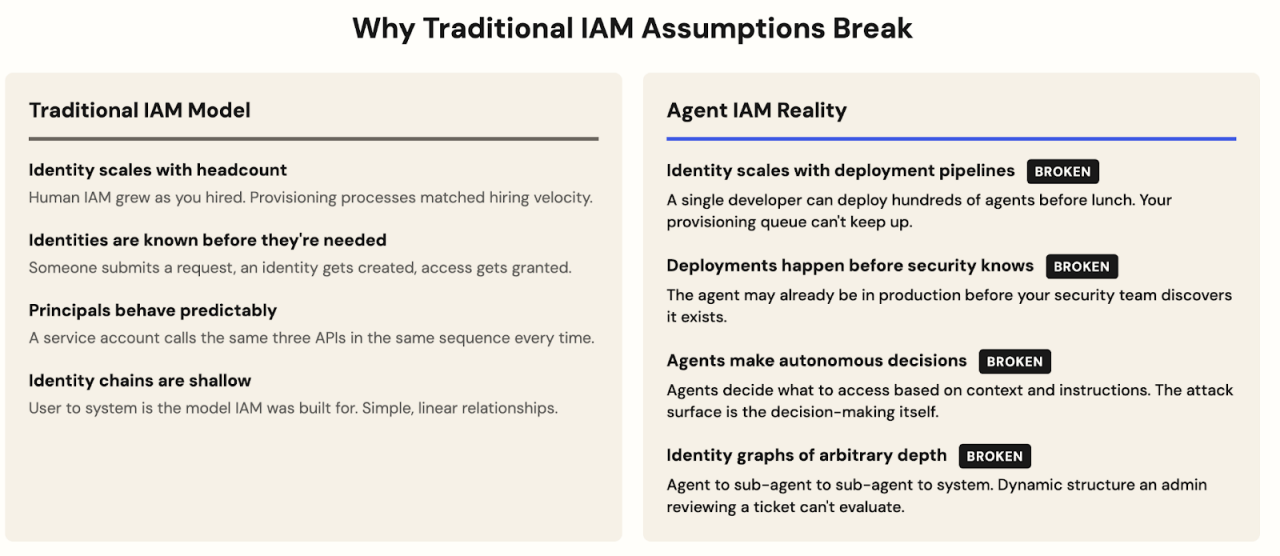 KI-Agenten brechen systematisch mit den Annahmen, auf denen herkömmliches Identity- und Zugriffsmanagement basiert, und erfordern somit einen grundlegenden Wandel der Governance-Architektur.
Die Abkehr von den herkömmlichen IAM-Regeln ist der Grund dafür, dass die Antwort auf die Personalfrage nicht mehr Administrator:innen sind, sondern eine bessere Architektur.
Alles, was autonom handelt, benötigt eine Identität
Bevor wir auf die Architektur eingehen, möchten wir zunächst einen zentralen Grundsatz erläutern, auf dem alles andere aufbaut. Unternehmen, die sich nicht daran halten, bringen sich früher oder später in eine Situation, die sich weder durch mehr Personal noch durch Tools beheben lässt:
Jeder KI-Agent, der in Ihrer Umgebung arbeitet, benötigt eine eigene Identität. Es darf keine Ausnahmen geben.
Keine gemeinsam genutzten Anmeldedaten, keine geliehenen Service-Accounts und auch nichts, das erst nach der Bereitstellung geklärt wird. Jeder Agent muss eine eigene Identität erhalten, die provisioniert wird, bevor er überhaupt mit einem Produktivsystem in Berührung kommt.
Woraus besteht eine vollständige Agentenidentität?
- Eine eindeutige, überprüfbare Kennung
- Ein klar definierter und dokumentierter Berechtigungsbereich für zulässige Aktionen
- Ein namentlich genannter menschlicher Benutzender, der für den Agenten verantwortlich ist
- Ein Audit-Protokoll mit den Aktionen des Agenten
- Klare Schritte zu Stilllegung und Widerruf
Was passiert ohne Identität? Wir wissen, dass Schatten-IT dazu führen kann, dass Daten an nicht autorisierten Orten gespeichert werden. Schatten-KI führt dagegen zu autonomen Aktionen in nicht autorisierten Kontexten. Sie können nichts prüfen, von dessen Existenz Sie nichts wissen. Sie können Berechtigungen nicht anpassen, die Sie noch gar nicht überprüft haben. Sie können den Zugriff für Agenten nicht widerrufen, die nie formell provisioniert wurden. Und Sie können unmöglich ein Team aufstellen, das groß genug ist, um Agenten aufzuspüren, die noch nie im System waren.
Jeder Agent benötigt eine verantwortliche Person
Wer ist verantwortlich, wenn ein Agent einen Vorfall verursacht?
Wenn Sie das nicht beantworten können, haben Sie ein Governance-Problem, das sich nicht durch mehr Personal lösen lässt. Um Verantwortlichkeit zu gewährleisten, müssen zwei Konzepte zusammenwirken.
- Personelle Verantwortung: Jedem Agenten muss eine benannte, verantwortliche Person im Unternehmen zugewiesen sein. Das sollte nicht die Person sein, die den Agenten vor drei Monaten entwickelt hat und inzwischen zu einem anderen Team gewechselt ist. Es sollte auch nicht der Anbieter sein, der das zugrundeliegende Modell bereitgestellt hat. Es geht darum, dass eine Person oder ein Team die Verantwortung übernimmt und beispielsweise die Berechtigungsbereiche des Agenten genehmigt, Benachrichtigungen bei ungewöhnlichem Verhalten erhält und die Verantwortung bei eventuellen Schäden übernimmt. Dies ist kein zusätzlicher Verwaltungsaufwand, für den eine weitere Fachkraft eingestellt werden muss, sondern eine Voraussetzung für die Governance von KI-Agenten und gehört somit zu ihrem Bereitstellungsprozess.
- Delegierung und die Befehlskette: Wenn ein Agent eine Aktion ausführt, sollte eine der folgenden Bedingungen zutreffen: Entweder er handelt im Rahmen seiner eigenen, explizit festgelegten Berechtigungen oder er handelt auf der Grundlage einer Befugnis, die ihm explizit von einem Menschen übertragen wurde. Beide Szenarien sind legitim, und beide müssen rückverfolgbar sein.
In Multi-Agenten-Systemen kann die Kette jedoch schnell komplexer werden:
Ein Mensch genehmigt einen Workflow → ein Orchestrator-Agent handelt aufgrund dieser Genehmigung → ein Unteragent wird mit delegiertem Berechtigungsbereich aufgerufen → ein API-Aufruf erreicht ein sensibles System.
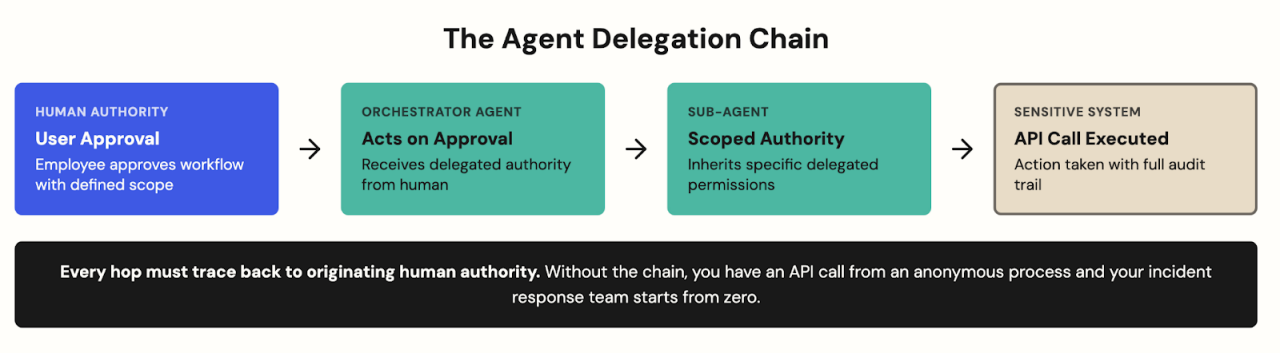 Jede Aktion in einem Multi-Agenten-Workflow muss auf die ursprüngliche menschliche Entscheidungsinstanz zurückgeführt werden können. Ohne diese Kette beginnt die Incident Response bei Null.
Jeder Schritt in dieser Kette muss bis zum ursprünglichen Mitarbeitenden zurückverfolgbar sein. Nicht nur, weil die Aufsichtsbehörden dies verlangen – das werden sie in jedem Fall –, sondern auch, weil Sie im Ernstfall genau rekonstruieren müssen, was passiert ist, warum der Agent davon ausging, autorisiert zu sein, und wo der Fehler aufgetreten ist. Ohne diese Kette gibt es nur einen API-Aufruf von einem anonymen Prozess, und Ihr Incident Response-Team beginnt bei Null.
Mit der Verantwortung wird geklärt, wer zuständig ist. Durch die Delegierung wird geklärt, wessen Berechtigungen genutzt werden. Zusammen sorgen diese beiden Grundsätze dafür, dass kein Agent ohne eine verantwortliche Person agiert. Und wenn sie von Grund auf richtig integriert werden, müssen die Grundsätze nicht durch eine Schar von Administrator:innen durchgesetzt werden.
Entwicklungsteams und Sicherheitsverantwortliche aufeinander abstimmen
Im Zentrum des Problems stehen zwei Teams, die unterschiedliche Anreize haben, und deren Arbeit sich oft nur in geringem Maße überschneidet.
- Das Entwicklungsteam arbeitet flexibel und fokussiert sich auf die Entwicklung neuer, beeindruckender Funktionen, die zur Lösung geschäftlicher Probleme beitragen. Identity Governance steht für sie nicht im Vordergrund – sie wollen vor allem schnell innovative Produkte auf den Markt bringen.
- Security-, IAM- und Compliance-Teams sind für die Sicherheitslage verantwortlich. Von neuen Agenten erfahren sie häufig erst nach der Bereitstellung, in einigen Fällen sogar deutlich später. Sie tragen die Verantwortung für die Risiken, an deren Entstehung sie meist gar nicht beteiligt waren.
Dieses gespannte Verhältnis ist nichts Neues. Ähnliches gab es bereits beim Umstieg auf die Cloud, bei Mobilgeräten und bei Schatten-IT. Bei KI-Agenten sind die Risiken jedoch höher. Ein falsch konfigurierter Cloud-Speicher-Bucket kann dazu führen, dass Daten passiv offengelegt werden. Ein falsch konfigurierter Agent kann hingegen aktiv Maßnahmen ergreifen, die zu deutlich größeren Schäden führen können.
Es ist kontraproduktiv, wenn das Security-Team dann einen Engpass schafft, indem es eine manuelle Überprüfung für jede Agenten-Bereitstellung verlangt. Dieser Ansatz verlangsamt nicht nur den gesamten Prozess, sondern hat sich in der Vergangenheit auch stets als erfolglos erwiesen. Das Entwicklungsteam findet Wege, diese Maßnahme zu umgehen, sodass die Agenten am Ende unkontrolliert laufen. Genau dieses Modell führt übrigens auch dazu, dass weitere Administrator:innen eingestellt werden müssen, um mit der Bereitstellungsgeschwindigkeit Schritt zu halten.
Die richtige Antwort ist eine gemeinsame Verantwortung mit automatisierter Durchsetzung: Das Security-Team legt die Richtlinien und Leitplanken im Voraus fest; das Entwicklungsteam bestimmt zum Zeitpunkt der Bereitstellung den Berechtigungsbereich und die verantwortliche Person; und die Pipeline übernimmt automatisch die Provisionierung. Das Security-Team erhält Transparenz, ohne sich dazwischen schalten zu müssen. Das Entwicklungsteam erhält einen schnellen Prozess, ohne Kontrollen zu umgehen. Und das Identity-Team kann sich mit der Entwicklung von Governance-Frameworks beschäftigen, statt Tickets zu bearbeiten.
Wie das Fundament für Identity-Sicherheit von KI-Agenten tatsächlich aussieht
Kommen wir nun zurück zur ursprünglichen Frage: „Was KI-Agenten können, ist wirklich beeindruckend. Aber wie viele Identity-Administrator:innen muss ich eigentlich einstellen, um sie alle zu verwalten?“
Die Antwort: Sie müssen die Größe Ihres Identity-Teams nicht linear an die Größe Ihrer Agentenflotte anpassen. Sie müssen stattdessen ein Fundament aufbauen, das auch ohne das Team skaliert.
Dieses Fundament besteht aus vier Komponenten.
- Agentenidentität als Code: Die Agentenidentität sollte kein manueller Provisionierungsschritt sein, sondern ein Artefakt der Bereitstellung: Sie wird in einem Manifest zusammen mit dem Code des Agenten definiert, im Rahmen des Entwicklungsprozesses überprüft und beim Rollout des Agenten automatisch provisioniert. Das Security-Review findet während der Code-Überprüfung statt, also noch vor der Produktivphase, und nicht als separater administrativer Schritt im Nachhinein.
- Klassenbasierte Governance: Sie werden nie Millionen von Agenteninstanzen direkt verwalten, sondern nur Dutzende von Agentenklassen. In einer Klasse werden die zulässigen Systeme und Datenzugriffsberechtigungen, die maximale Datenklassifizierungsstufe sowie die Eskalationsfälle und Audit-Anforderungen festgelegt. Einzelne Agenten erben diese Eigenschaften automatisch von den Klassen. So ist der Verwaltungsaufwand nicht von den zum jeweiligen Zeitpunkt laufenden Instanzen abhängig, sondern von der Zahl der verwendeten Klassen.
- Zero-Standing-Privilegien: KI-Agenten sollten keine dauerhaften Berechtigungen besitzen. Stattdessen sollte für jede Aktion eine zeitlich begrenzte Berechtigung mit definiertem Berechtigungsbereich für eine spezifische Aufgabe erforderlich sein. Wenn die Aufgabe abgeschlossen ist, laufen die Anmeldedaten ab. Dies reduziert nicht nur die Angriffsfläche, sondern macht auch das Skalierungsproblem handhabbar. Zudem wird Wildwuchs an Berechtigungen verhindert, die sich ansonsten für Tausende Agenten ansammeln würden und von jemandem überprüft und bereinigt werden müssten. Die Ausstellung von Anmeldedaten ist ein Governance-Ereignis, das automatisch protokolliert wird.
- Die Delegierungskette als Infrastruktur: Bei Multi-Agenten-Workflows muss die Delegierungskette als zentrales architektonisches Element behandelt werden. Wenn die Infrastruktur dies technisch erzwingt, ist die Rückverfolgbarkeit automatisch gegeben. Wenn es eine konzeptionelle Vorgabe ist, die manuell überprüft werden muss, wird daraus eine zeitraubende Daueraufgabe.
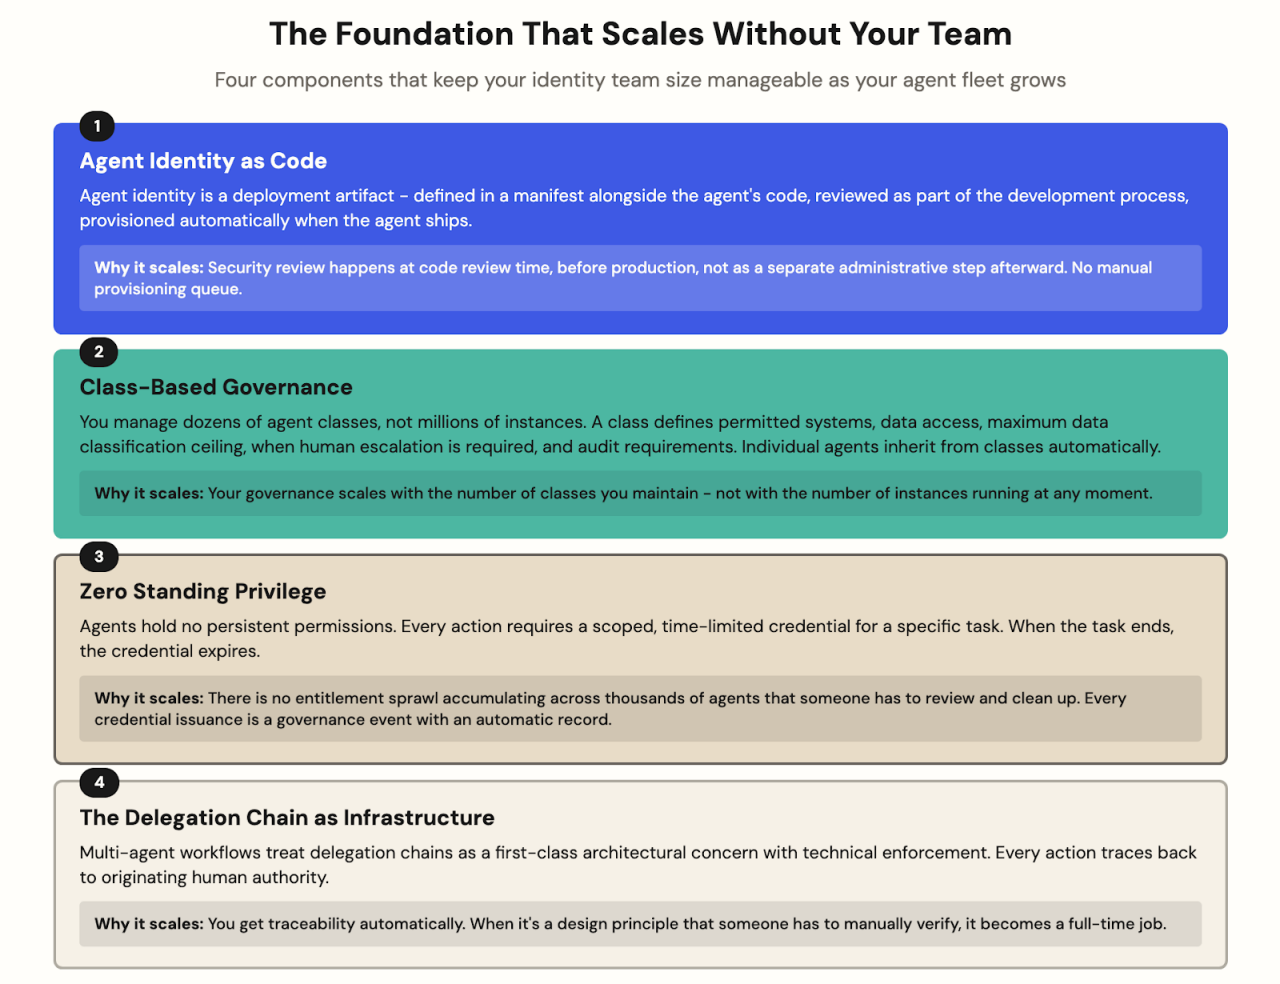 Das Fundament, mit dem Sie die Verwaltung Ihrer KI-Agenten skalieren können, ohne die Größe Ihres Identity-Teams linear an die Größe Ihrer Agentenflotte anpassen zu müssen.
Identity-Management war schon immer ein kontinuierlicher Prozess – das wird sich durch KI-Agenten auch nicht ändern
Die Provisionierung einer Agentenidentität zum Zeitpunkt der Bereitstellung ist der Beginn und nicht das Ende der Governance. Doch auch auf dieses Problem lautet die Antwort Automatisierung und Disziplin statt mehr Personal.
- Agenten müssen in regelmäßige Zugriffsprüfungen einbezogen werden. Ist der Agent noch aktiv? Ist der Berechtigungsbereich noch angemessen? Hat sich der Geschäftskontext geändert? Automatisieren Sie die Datenerfassung. Lassen Sie Menschen über Ausnahmen entscheiden. Gestalten Sie den Prozess nicht so, dass Ihr Team alle drei Monate Tausende Agenten manuell überprüfen muss. Entwickeln Sie stattdessen ein System, bei dem nur die Dinge überprüft werden müssen, für die menschliches Urteilsvermögen erforderlich ist.
- Passen Sie die Berechtigungen an das tatsächliche Verhalten an. Agenten werden häufig mit einem größeren Berechtigungsbereich bereitgestellt, als sie tatsächlich benötigen. Nutzungsdaten zeigen die Diskrepanz zwischen dem, worauf ein Agent tatsächlich zugreift, und dem, worauf er Zugriffsberechtigungen hat. Überlassen Sie es dem System, diese Lücke zu erkennen. Ihre Mitarbeitenden müssen die Anpassung dann nur noch genehmigen. So verhindern Sie Berechtigungswildwuchs, für dessen nachträgliche Entwirrung ein enormer Verwaltungsaufwand nötig wäre.
- Stilllegungen sind ein elementarer Prozess. Wenn ein Workflow außer Betrieb genommen wird, sollten die zugehörigen Agenten automatisch stillgelegt werden. Zombie-Agenten, die bereitgestellt, aber vergessen wurden und weiterhin gültige Anmeldedaten besitzen, gehören zu den größten Risikofaktoren in agentenbasierten Umgebungen. Zudem sind sie die direkte Folge davon, Stilllegungen als manuellen Prozess zu betrachten, der irgendwann im Nachgang erledigt werden soll.
Die Antwort auf die Frage
Wie viele Identity-Administrator:innen müssen Sie also einstellen, um Tausende KI-Agenten zu verwalten?
Wenn Sie das richtige Fundament haben, lautet die Antwort: nicht so viele, wie Sie denken, und weit weniger als ohne solides Fundament.
Sie benötigen eigentlich nur einen kleinen Kreis von Mitarbeitenden, die Richtlinienrahmen und Pipeline-Integrationen entwickeln sowie Verhaltenssignale im großen Maßstab analysieren. Zudem sollten sie Entwicklungsteams zur Einhaltung von Governance-Standards anhalten.
Was Sie hingegen nicht benötigen – und was ohnehin nicht funktionieren würde –, ist ein neues Team, das Agentenidentitäten manuell über eine Ticket-Warteschlange bereitstellt, überprüft und stilllegt. Dieses Modell wäre nicht skalierbar und würde zusammenbrechen, bevor in Ihrer Umgebung Hunderte, geschweige denn Tausende Agenten aktiv sind.
Die Unternehmen, die erfolgreich KI-Agenten in großem Maßstab verwalten, werden nicht diejenigen sein, die am schnellsten neue Mitarbeitende einstellen. Es werden vielmehr diejenigen sein, die frühzeitig das richtige Fundament legen – solange die Flotte noch klein genug ist, um sie zu formen, und bevor die Personalfrage unlösbar wird.
Folgende fünf Dinge sollten Sie tun, bevor Ihre Agentenflotte noch größer wird:
- Verankern Sie das folgende Prinzip intern: Jeder Agent erhält ab sofort und ausnahmslos eine Identität.
- Machen Sie eine Bestandsaufnahme aller bereits laufenden Agenten, einschließlich solcher, die nicht formell bereitgestellt wurden.
- Machen Sie die Zuweisung einer verantwortlichen Person zur Voraussetzung für jeden Agenten im Produktivbetrieb.
- Definieren Sie die verschiedenen Stufen von Agentenklassifizierungen, bevor Sie sie im großen Maßstab verwenden.
- Machen Sie eine Identität zur Bereitstellungsvoraussetzung, statt sie erst im Nachhinein zu prüfen.
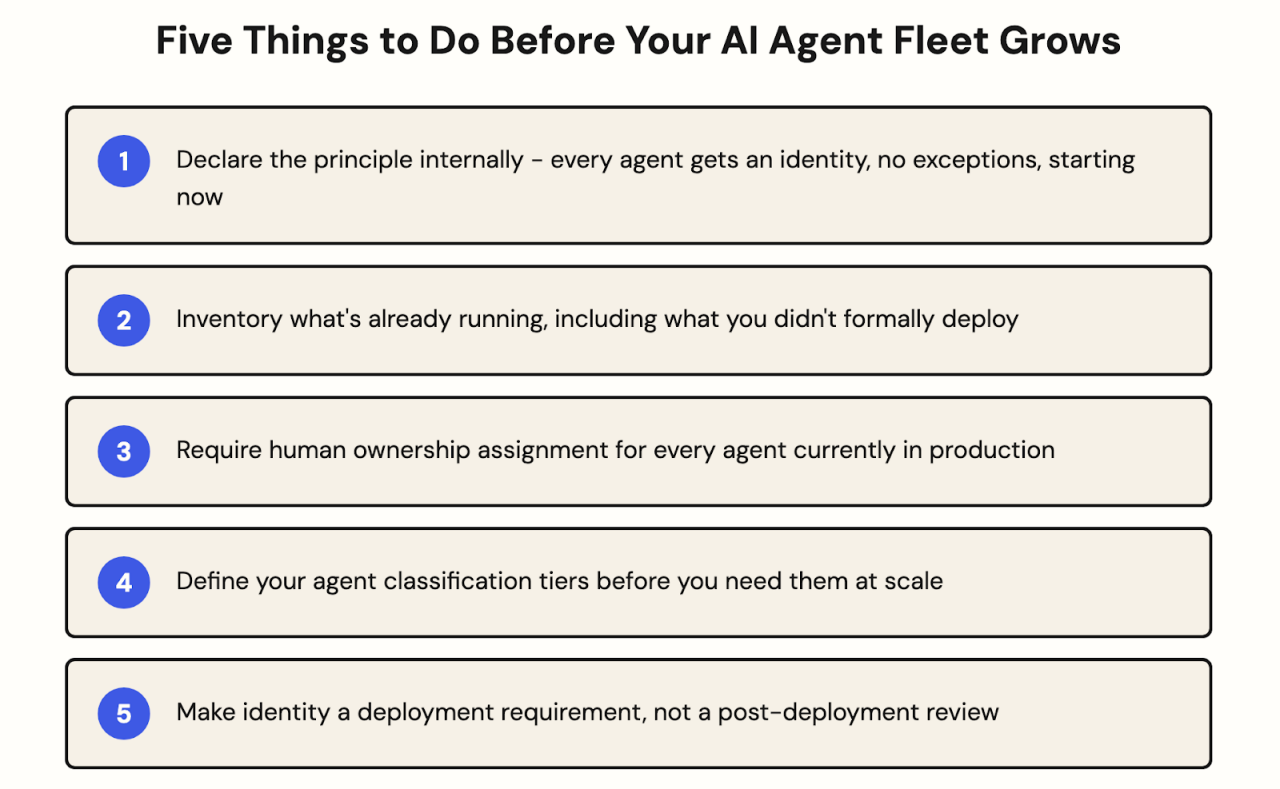 Konkrete Maßnahmen, die Sicherheits- und IT-Verantwortliche jetzt umsetzen sollten, solange die Agentenflotte noch klein genug ist, um sie zu formen.
Die explosionsartige Zunahme von Agenten ist kein Problem von morgen. KI-Agenten halten bereits jetzt Einzug in die Produktivumgebungen von Unternehmen, die sich noch nicht endgültig entschieden haben, wie sie diese verwalten sollen.
Jetzt ist der richtige Zeitpunkt, die passenden Strukturen dafür zu schaffen. Die Lösung ist dabei nicht mehr Personal, sondern eine bessere Architektur.
Sie wollen das richtige Fundament zur Governance von KI-Agenten legen? Okta schließt die Lücke: Mit uns kann das Entwicklungsteam schneller bereitstellen und das Security-Team von skalierbarer Governance profitieren. Mehr erfahren Sie hier.


