




Okta hat es sich zur Aufgabe gemacht, jedem Menschen sicheren Zugang zu jeder Technologie zu ermöglichen. Okta verarbeitet jeden Monat Milliarden Authentifizierungen und gewährleistet, dass Benutzende sicher auf ihre bevorzugten Anwendungen zugreifen können. Hinzukommt, dass Okta Monat für Monat Milliarden schädlicher Anfragen blockiert und auf diese Weise die Identitäten seiner Kundinnen und Kunden vor Angriffen schützt.
Die Okta Platform bietet eine mehrschichtige Strategie zum Schutz von Identitäten. Ein wichtiger Aspekt einer solchen umfassenden Strategie ist das Risiko. Die Okta Platform berechnet Risiken auf verschiedenen Ebenen und stellt eine wichtige Komponente unserer Schutzstrategie dar. Wir empfehlen unseren Kundenunternehmen dringend, risikobasierte Richtlinien so zu konfigurieren, dass für Anmeldungen mit hohem Risiko MFA angefordert wird.
Die Bewertung des Identity-Risikos basiert bei Okta heute auf unserem ML-Stack, so wie Sie dies von einem etablierten Sicherheitsunternehmen sicherlich erwarten. Wir erfassen jedes relevante Authentifizierungs- oder Identity-Ereignis, wandeln es in einen strukturierten Datensatz um (IP-Adresse, Gerät, Benutzeragent, Land usw.), entwickeln manuell eine große Anzahl von Merkmalen und speisen diese dann in ein Machine-Learning-Modell ein.
Dies ermöglicht letztendlich die Bewertung des Identity-Risikos in Produkten wie Identity Threat Protection mit Okta AI, bei dem Benutzer- und Session-Risiken kontinuierlich anhand von Netzwerk-, Geräte- und anderen Signalen bewertet werden.
Mit dem Aufkommen von LLMs sind wir allerdings dazu übergegangen, mit neuen Ansätzen zu experimentieren und uns zu fragen, wie wir sie für die adaptive Risikobewertung nutzen können. Letztendlich handelt es sich bei Sicherheitsprotokollen im Grunde um Sequenzen aus strukturiertem Text: Ereignistypen, IP-Adressen, Benutzeragenten, Org-IDs, Geo-Signale und so weiter. Können wir, anstatt all dies in einen festen Merkmalsvektor zu komprimieren, die Protokolle wie nativen Textstrom verarbeiten und die Identity-Risikobewertung mithilfe eines LLM direkt anhand der Systemprotokolldaten vornehmen?
In diesem Beitrag wird ein solches Experiment beschrieben. Es geht um eine LLM-basierte adaptive Risikobewertung, die sequentielle Muster lernt und Anomaliebewertungen mithilfe eines probabilistischen Ziels generiert.
Herkömmliche ML-Bewertung
Bei einem Anmeldeablauf wird nicht nur ein Ereignis, sondern eine ganze Zeitleiste zusammengehöriger Ereignisse generiert. Für eine einzelne Identität könnte der Ausschnitt eines solchen Verlaufs (vereinfacht) wie folgt aussehen:
t₁: event_type=user.session.start …
t₂: event_type=user.authentication.sso country=Germany
ip_address=145.224.xxx.xxx user_agent_raw=SFDC-Callout/64.0
browser=UNKNOWN os=Unknown device=Unknown as_org=amazon.com inc.
request_uri=/oauth2/.../v1/token …
t₃: event_type=inline_hook.response.processed …
t₄: event_type=user.authentication.sso …
t₅: event_type=user.session.end …
Im Laufe der Zeit wird der Benutzerverlauf zu einer Sequenz:
[e1, e2, …, e(n−1), en]
In einer herkömmlichen Pipeline speisen wir diese Rohereignisse fast nie direkt in ein Modell ein. Stattdessen fassen wir die Sequenz zu technisierten Merkmalen zusammen, die über Zeitfenster oder den Verlauf berechnet werden, zum Beispiel:
- „Ist diese IP-Adresse neu für diese Person?“
- „Ist diese ASN neu für diese Org?“
- „Gab es in der Vergangenheit ähnliche Benutzeragenten?“
- … usw.
Das eingehende Ereignis wird zu einem numerischen Merkmalsvektor, der in Relation zum bisherigen Benutzerverlauf steht, zum Beispiel:
features(event) → x ∈ ℝᵈ
Das Modell lernt die Zuordnung:
risk = f(x)
wobei f in der Regel ein Machine-Learning-Modell ist.
Der Haken dabei ist, dass der Ereignisverlauf für diese Identität zu einigen wenigen Zählern und Kennzeichen (bzw. Merkmalen) komprimiert wird. Das Modell „sieht“ den zeitlichen Verlauf der Identität nicht vollumfänglich, sondern lediglich eine Momentaufnahme und einige aggregierte Zahlen. Auch der sequentielle Aspekt geht bei dieser Komprimierung verloren.
Warum LLM?
LLMs glänzen genau bei dem, was Sicherheitsprotokolle darstellen: Sequenzen von semistrukturiertem Text. Anstatt eine einzelne Anmeldung isoliert zu betrachten, kann ein LLM eine Zeitachse aller wichtigen Ereignisse für eine Benutzerin oder einen Benutzer oder einen Agenten auswerten:
„Diese Identität authentifiziert sich normalerweise mit einer sehr spezifischen Benutzeragent-Zeichenfolge, während der Geschäftszeiten, von Deutschland aus, über einen API-Client.“
Daraus kann das Modell implizit Folgendes lernen:
- Wie „normal“ für die einzelnen Identitäten aussieht
- Welche Kombinationen von Feldern häufig zusammen vorkommen
- Wann ein neues Ereignis auf subtile Weise von der Basislinie abweicht
- Ob ein neues Ereignis überhaupt eine Anomalie auf globaler Ebene darstellt
Es gibt drei große Vorteile:
- Sequenzen
LLMs können mehrere Ereignisse in einer Sequenz lesen, nicht nur eine einzelne Momentaufnahme. Sie betrachten die gesamte Sequenz als Geschichte und beurteilen, ob das nächste Kapitel Sinn ergibt. - Weniger manuelle Entwicklung von Merkmalen
Anstatt Hunderte Merkmale manuell zu entwerfen, lassen wir das Modell Muster direkt aus nicht aufbereitetem Ereignistext lernen. Das spart Zeit bei der Entwicklung.
- Verbesserte Generalisierung bei neuen Mustern
Da das Modell vollständige Sequenzen sieht, kann es überraschende Kombinationen erkennen, die es für diese Identität noch nicht gesehen hat. Das gilt auch dann, wenn wir keine Funktion für dieses spezifische Muster erstellt haben.
Das bedeutet: Wir komprimieren nicht alles in eine einzige Momentaufnahme, sondern speisen die gesamte Ereignissequenz für Benutzende oder Agenten in ein fein abgestimmtes LLM-Modell ein und können Fragen stellen wie: Unter Berücksichtigung des normalen Verhaltens dieser Identität, sieht das nächste Ereignis normal oder seltsam aus?
Grob gesagt geht es bei dem System um zwei wesentliche Aufgaben:
- Einem LLM beibringen, das nächste Ereignis anhand des historischen Benutzerprofils sowie der vorherigen Ereignisse und Token vorherzusagen
- Die „Überraschung“ des Modells zur Anomalie-/Risikobewertung heranziehen
Nachfolgend werden wir auf beides näher eingehen.
LLM-Feinabstimmung
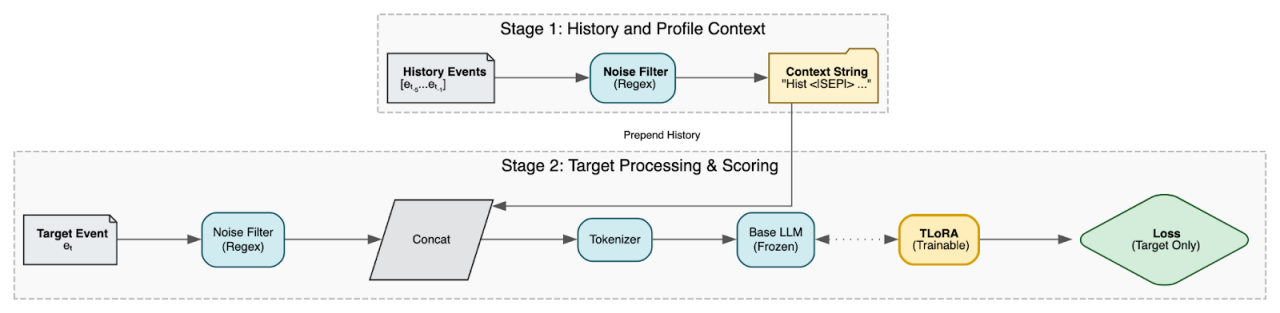
Bei der Feinabstimmung eines LLM handelt es sich im Prinzip um eine Möglichkeit, dem Modell die Muster beizubringen, die wir tagtäglich in den Identity-Daten von Okta vorfinden. Der von uns verwendete Versuchsaufbau besteht aus drei Phasen: Aufbau eines historischen Benutzerkontexts oder Benutzerprofils, Konditionierung des LLM auf dieses Profil und Trainieren des LLM zur Vorhersage des nächsten Ereignisses.
1. Ereignisverlauf in ein Profil umwandeln
Wir beginnen für eine gegebene Identität mit einer Sequenz vergangener Ereignisse:
history = [e₁, e₂, …, eₙ₋₁],
current event to score = eₙ.
Anstatt diese in abstrakte Vektoren umzuwandeln, behandeln wir die Rohtextsequenz als Profil. Rohprotokolle enthalten jedoch stark entropisches Rauschen (zufällige Transaktions-IDs, Hashes, Nonces), das das Modell irritiert. Wir leiten deshalb jedes Ereignis durch einen Rauschfilter, der diese zufälligen Werte durch statische Platzhalter ersetzt (z. B. <ID>).
Anhand dieser bereinigten Textsequenzen wird anschließend ein Profil p erstellt. Dadurch wird die Information „wie diese Identität typischerweise aussieht“ über die jüngste Historie hinweg – Länder, ASNs, Benutzeragenten und Ablaufmuster – in einem Format erfasst, das vom LLM nativ gelesen werden kann.
2. Ein Sprachmodell auf das Profil konditionieren
Anschließend ziehen wir ein Sprachmodell im GPT-Stil heran und modifizieren die Eingabe dahingehend, dass es nicht nur das Ereignis eₙ sieht, sondern auch den historischen Kontext p.
Dazu verwenden wir kontextbezogenes Prompting. Wir verketten die historischen Ereignisse (Profil) mit dem Zielereignis und trennen sie durch ein spezielles Token. Das Modell sieht nicht nur das Ziel:
[tokens(eₙ)]
Es erfasst auch die vollständige Verhaltensbeschreibung:
[tokens(e₁), , tokens(e₂), ... , tokens(eₙ)]
Dadurch wird das Modell gezwungen, Folgendes zu kodieren: „Hier ist das sequenzielle Verhalten dieser Identität; prognostiziere die nachfolgenden Token in diesem Kontext.“
Um dies effizient abzubilden, trainieren wir nicht das gesamte Sprachmodell neu. Wir frieren das Basismodell ein und fügen kleine Adapterebenen auf niedrigem Rang hinzu. Dazu verwenden wir eine intern entwickelte Feinabstimmungsmethode mit der Bezeichnung TLoRA. Es werden nur die Adapter trainiert, sodass der Aufwand gering gehalten wird.
3. Trainingsziel
Die Trainingsdaten stammen aus Sequenzen realer Ereignisverläufe. Für jede Sequenz gehen wir folgendermaßen vor:
- Wir speisen die vollständige Sequenz Profile + Target in das Modell ein.
- Wir berechnen den Verlust ausschließlich für das Zielereignis eₙ.
Wir trainieren das Modell mit einem Standard-Sprachmodellierungsziel (Vorhersage des nächsten Tokens): Es weist jedem Token im letzten Ereignis eine hohe Wahrscheinlichkeit zu, basierend auf dem spezifischen Benutzerverlauf. Das Modell wird belohnt, wenn es die nächste Benutzeraktion auf der Grundlage des bisherigen Verhaltens korrekt vorhersieht, und es wird bestraft, wenn es „überrascht“ ist.
Anhand zahlreicher Identitäten und Sequenzen erlangt das Modell mit der Zeit ein Verständnis vom „normalen nächsten Ereignis“, da es auf das spezifische Benutzerprofil p konditioniert wurde.
Perplexitätsbasierte Risikobewertung
Nachdem das Modell trainiert wurde, können wir seine „Überraschung“ für die Anomaliebewertung nutzen.
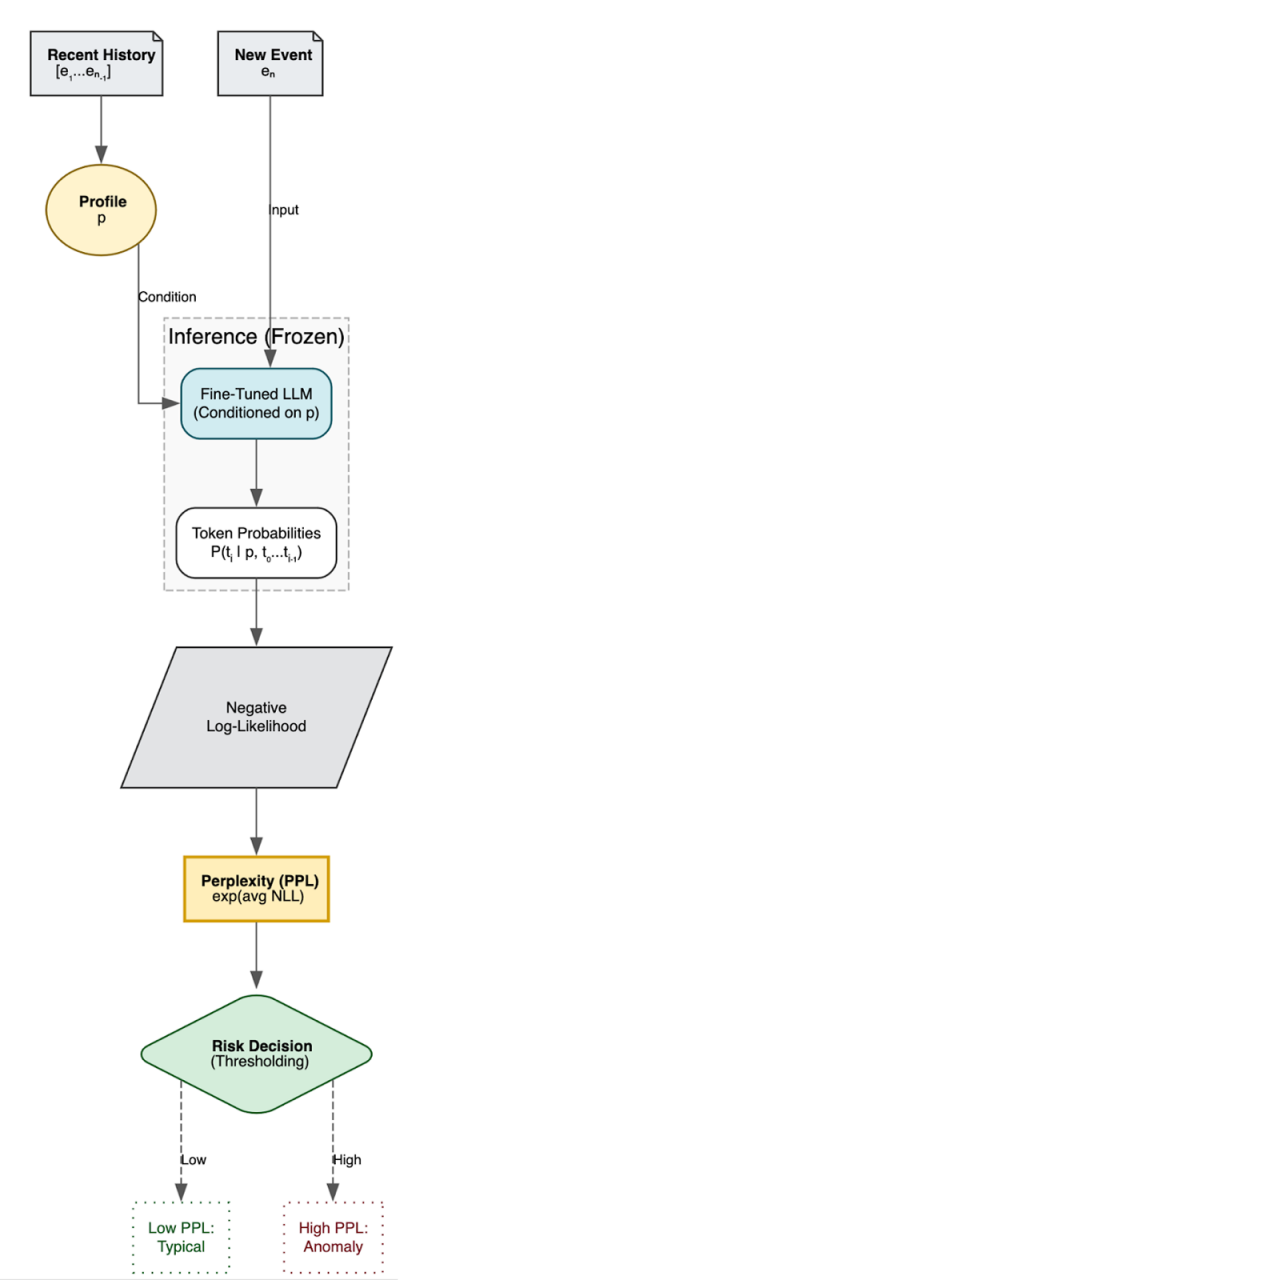
Führen Sie für ein neues eingehendes Ereignis folgende Schritte aus:
- Rufen Sie das Profil p aus dem jüngsten Verlauf der Identität ab.
- Speisen Sie das Profil und das tokenisierte Ereignis in das Modell ein.
- Stellen Sie die Frage: Wie wahrscheinlich war das Vorkommnis jedes Tokens dieses Ereignisses angesichts des Profils und der vorherigen Token?
Daraus ergibt sich eine negative Protokollwahrscheinlichkeit (Log-Likelihood, NLL) pro Token und Perplexität:
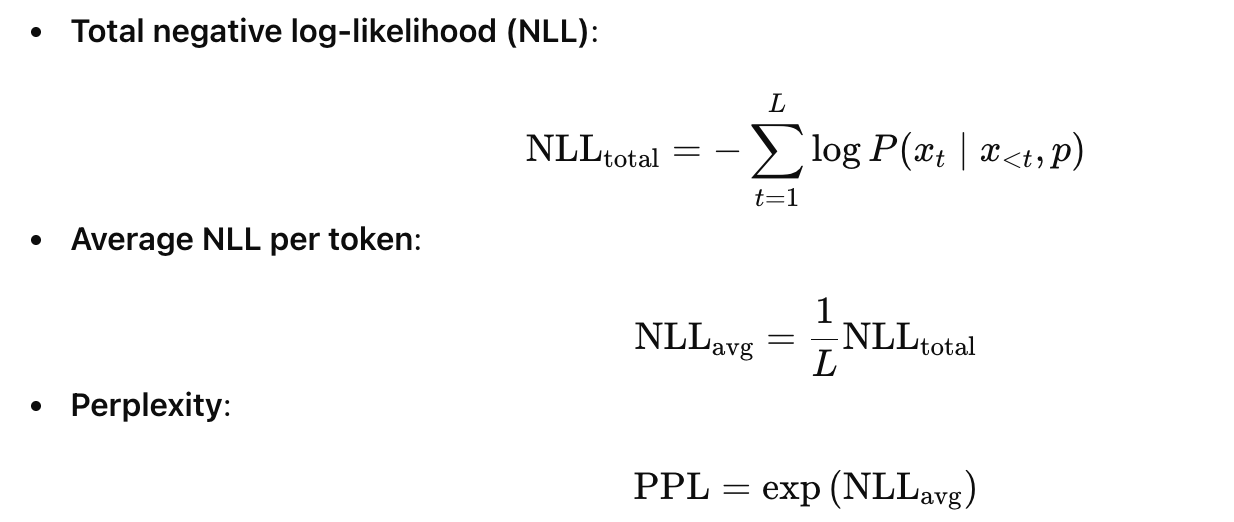
Standardprotokollzeilen enthalten jedoch eine beträchtliche Menge an statischem Vorlagentext (boilerplate), der das Signal überdeckt. Deshalb berechnen wir anstelle eines einfachen globalen Durchschnittswerts die Spitzenperplexität. Wir isolieren die überraschendsten Top-K-Token (d. h. die höchsten NLL-Werte) im Zielereignis, mitteln nur diese und exponieren sie anschließend. Dadurch wird sichergestellt, dass sich die Bewertung auf die Informationen (z. B. Land, ISP, Gerät) und nicht auf die Struktur konzentriert.
Operationell wird die Risikobewertung aus dieser Perplexität abgeleitet:
- Niedriger PPL-Wert → Niedriges Risiko: Das Ereignis erscheint für diese Identität sehr typisch.
- Hoher PPL-Wert → Hohes Risiko: Das Ereignis erscheint ungewöhnlich, wenn man alles berücksichtigt, was das Modell gelernt hat und basierend auf dem Verlauf dieser Identität abgeleitet wurde.
Da das Modell auf das Identitätsprofil konditioniert wurde, ist es von sich aus adaptiv.
Konzeptionelles Beispiel
Um zu veranschaulichen, wie dies in der Praxis funktioniert, betrachten wir eine reale Sequenz, die von unserem Modell verarbeitet wurde.
Das Modell liest den Ereignisverlauf wie eine Erzählung. Es erstellt ein „Profil“ für den Benutzer bzw. die Benutzerin auf der Grundlage des Kontexts, d. h. Standort, Gerät und übliche Authentifizierung. Anschließend überprüft das Modell das Zielereignis, um festzustellen, ob es zu der Erzählung passt.
Im Folgenden finden Sie einen vereinfachten Auszug einer Benutzer-Session. Stark entropisches Rauschen (wie IDs und Hashes) haben wir entfernt, um genau aufzuzeigen, worauf sich das Modell konzentriert. Dies ist eine vereinfachte Version.
1. Der Kontext (Profil)
Das Modell verarbeitet diese Ereignisse zuerst, um den aktuellen Benutzerstatus zu verstehen.
[T-3] Session Start xevent_type=user.session.start | country=United
[T-2] MFA Verification event_type=user.authentication.verify |
country=United States | os=Windows 10 | device=Computer |
result=SUCCESS
[T-1] Internal Auth event_type=security.internal.authentication |
country=United States | os=Windows 10 | device=Computer
2. Die Anomalie (Zielereignis)
Der Benutzer bzw. die Benutzerin greift plötzlich auf die Administrator-App zu, aber der Kontext hat sich drastisch verändert.
[T-0] Admin Access event_type=user.session.access_admin_app |
country=India | city=Chennai | os=Android | device=Mobile
Berechnung der Bewertung
Wenn das Modell das Zielereignis verarbeitet, berechnet es die Wahrscheinlichkeit jedes Tokens unter Berücksichtigung des Profils.
Basierend auf dem etablierten Kontext von „United States“ und „Windows“ prognostiziert das Modell mit hoher Wahrscheinlichkeit, dass diese Token erneut vorkommen werden. Wenn es stattdessen auf India und Android trifft, sinkt die Wahrscheinlichkeit für diese spezifischen Begriffe gegen Null. Diese kontextabhängige Diskrepanz führt zu einem massiven Anstieg des Verlusts für diese Token, wodurch die Bewertung der Spitzenperplexität so stark ansteigt, dass die Anomalie gekennzeichnet wird.
Durch Verwendung der Spitzenperplexität isoliert das LLM den semantischen Widerspruch: Der Benutzer bzw. die Benutzerin kann physisch nicht sofort von Kansas nach Chennai reisen und mitten im Geschehen das Gerät wechseln.
Blick in die Zukunft
Die LLM-basierte Bewertung des Identity-Risikos befindet sich noch in der experimentellen Phase, aber sie weist uns einen konkreten, mathematisch fundierten Weg nach vorne:
- Wir gehen von manuell entwickelten Merkmalsvektoren zu Sequenzmodellen mit Profilkonditionierung über.
- Wir erhalten eine auf Prinzipien basierende Anomaliebewertung unter Verwendung von NLL und Perplexität anstelle von Ad-hoc-Regelgewichtungen.
- Wir können diese Anomaliebewertung als zusätzliches Signal in bestehende Risikopipelines integrieren, anstatt zu ersetzen, was heute funktioniert.
Zukünftige Arbeiten werden sich auf die Verbesserung der Profilerstellung, die Kalibrierung der Zuordnung zwischen Perplexität und Risiko und mögliche Erweiterungen konzentrieren, wie die Generierung von Erläuterungen in natürlicher Sprache, warum ein Ereignis als überraschend eingestuft wurde.


