



Was ist das KI-Last-Mile-Problem?
Das KI-Last-Mile-Problem tritt auf, wenn der am Zugangspunkt hergestellte Identitätskontext an Qualität verliert, bevor er das System erreicht, das die eigentliche Arbeit ausführt. Letztendlich führt die Ressource die Autorisierung anhand eines Berechtigungsnachweises wie eines virtuellen Schlüssels, eines Service-Accounts oder eines gemeinsam genutzten Clients durch, anstatt anhand einer überprüfbaren Kette, die zeigt, welcher Agent handelt, in wessen Auftrag und unter welchen Einschränkungen. Least Privilege lässt sich an der einzigen Stelle, an der es darauf ankommt, nicht mehr durchsetzen, und jede nachgelagerte Aktion sieht im Audit-Protokoll gleich aus.
Ich habe eine Variante dieses Gesprächs nun schon oft mit verschiedenen Teams in unterschiedlichen Branchen geführt, und meistens beginnt es auf die gleiche Weise. In einer Bank, einem Versicherungsunternehmen oder einem beliebigen regulierten Unternehmen möchten Entwickler:innen einen KI-Programmierassistenten (wie Claude Code oder Codex) nutzen, und das Plattform-Team tut das Kluge und Naheliegende: Es platziert ein KI-Gateway vor all seinen Ressourcen. Dieses Gateway bietet eine zentrale Stelle, um Anfragen an Modelle weiterzuleiten, Budget- und Ratenbegrenzungen durchzusetzen und den Zugriff auf interne Tools über das Model Context Protocol (MCP) zu vermitteln. Ich verstehe den Impuls dahinter, aber ich habe das Gefühl, dass es dem „Service-Account-Modell“ für KI-Agenten ähnelt und die Dinge in der Praxis oft recht pikant werden.
Grundsätzlich authentifiziert ein Gateway einen Schlüssel. Es kann keine Person authentifizieren, und bis eine Anfrage die eigentliche Ressource erreicht – das interne Tool, die Datenquelle oder was auch immer sich am anderen Ende befindet –, kann nachgelagert niemand den Unterschied erkennen. Das zu beheben, ist keine Frage einer strengeren Konfiguration des Gateways. Das bedeutet, dem Ganzen eine echte Identität zugrunde zu legen: Der Agent erhält seine eigenen Anmeldedaten, jeder Aufruf trägt die Identität der dahinterstehenden Person, und die Ressource selbst gleicht diese Anmeldedaten mit den Berechtigungen dieser spezifischen Person ab. Derselbe Agent, dasselbe Gateway und derselbe Code liefern nun eine andere Antwort, je nachdem, wer tatsächlich fragt.
Warum scheitern KI-Gateways bei der nachgelagerten Identitätsdurchsetzung?
Die meisten dieser Gateways funktionieren heute so, dass der Agent (ein Programmierassistent) am Ende den Schlüssel hält. Der Agent authentifiziert sich mit diesem virtuellen Schlüssel beim Gateway; das Gateway leitet die Anfrage dann an ein Modell oder einen MCP-Server weiter.
Das Problem tritt ganz am Ende dieser Kette auf. Sobald eine Anfrage das Gateway passiert hat, gibt es für die Ressource am anderen Ende keine wirkliche Möglichkeit zu erkennen, wer tatsächlich dahintersteckt. Alles, was es sieht, ist der Schlüssel. Keine Person. Nicht einmal zuverlässig ein bestimmter Agent. Einfach eine Anmeldeinformation, die jede:r mit Zugriff darauf an diesem Tag hätte verwenden können.
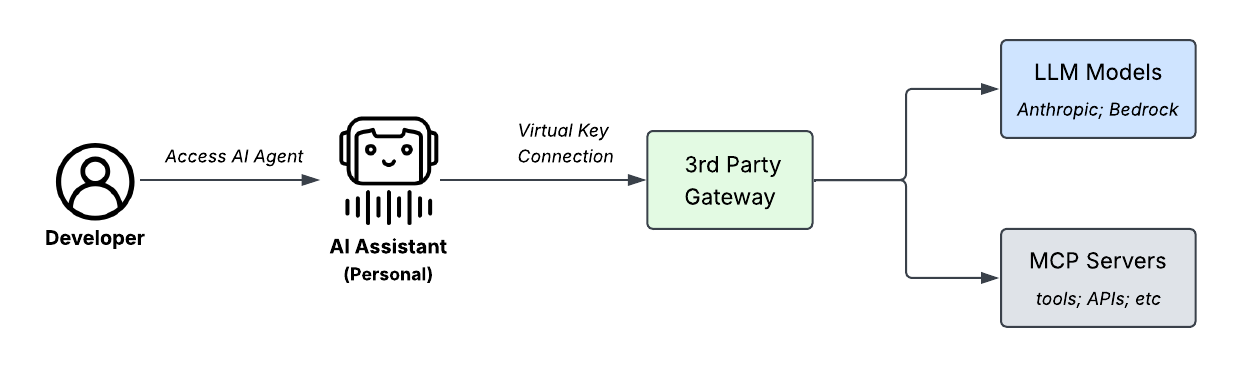 Das Muster, mit dem die meisten Teams beginnen: Ein:e Entwickler:in, ein persönlicher KI-Assistent mit einem virtuellen Schlüssel, ein Gateway und alles, was nachgelagert ist. Nichts in dieser Kette überträgt die Identität der Entwickler:in über das Gateway hinaus.
Ich habe in Foren einige Bezeichnungen für dieses Problem gesehen, und diejenige, auf die ich mich festgelegt habe, lautet „das Problem der letzten Meile“. Das Gateway bringt Sie schon fast ans Ziel: es authentifiziert etwas (zum Beispiel einen virtuellen Schlüssel) und leitet letztendlich zur richtigen Ressource weiter. Es überträgt jedoch keine Informationen bezüglich Identität, Berechtigungen oder Autorisierung. Bis die Anfrage den MCP-Server oder das Modell erreicht, weiß das System in der Regel nichts über die Identität, die die Anfrage stellt.
Zentrale Sicherheitslücken schlüsselbasierter KI-Gateways
- Statische Anmeldedaten als Identität: Ein statischer Schlüssel fungiert als Identität, nicht als aktive, widerrufbare Assertion darüber, wer hinter einer Anfrage steht (ähnlich einem Service-Account-Modell).
- Standardmäßig übermäßige Zugriffsberechtigungen: Der Zugriff ist in der Regel standardmäßig offen, bis ihn jemand gezielt einschränkt.
- Durchsetzung: Die Ressource hat keine Obergrenze für die Durchsetzung, selbst wenn das Gateway protokolliert: „Dieser Schlüssel hat dieses Tool aufgerufen“, weil niemand in der Kette jemals gefragt hat: „Ist diese bestimmte Person für diese bestimmten Daten zugriffsberechtigt?“
Das fällt bei einem Audit wirklich auf. Wenn Sie ein KI-orientiertes Team fragen, wer auf einen Datensatz oder einen MCP-Server zugegriffen hat und aus welchem Grund, wird die Antwort Schweigen sein.
Die Schwachstelle des Gateways als Durchsetzungspunkt
Ich glaube nicht, dass dies eine Konfigurationslücke ist, die Sie schließen können, indem Sie weitere Regeln in das Gateway schreiben. Eine echte Entscheidung erfordert im Moment der Entscheidung drei Dinge:
- Was der Agent tun kann
- Wozu der spezifische Mensch berechtigt ist
- Was die Richtlinie der Ressource zulässt
Ein Gateway hat durch sein Design immer nur Einblick in das Erste davon, und oft nicht einmal das, sondern lediglich: „Jemand hat einen gültigen Schlüssel vorgelegt.“
Warum scheitert das „nachträgliche Hinzufügen“ eines Identity-Anbieters?
Ein häufiger nächster Schritt ist die Anbindung eines Identity-Anbieters (IdP) und die Durchführung eines On-Behalf-Of-Token-Austauschs (sofern dies unterstützt wird), sodass der Agent das Access Token der Benutzer:in übernimmt, anstatt über einen eigenen statischen Schlüssel zu verfügen.
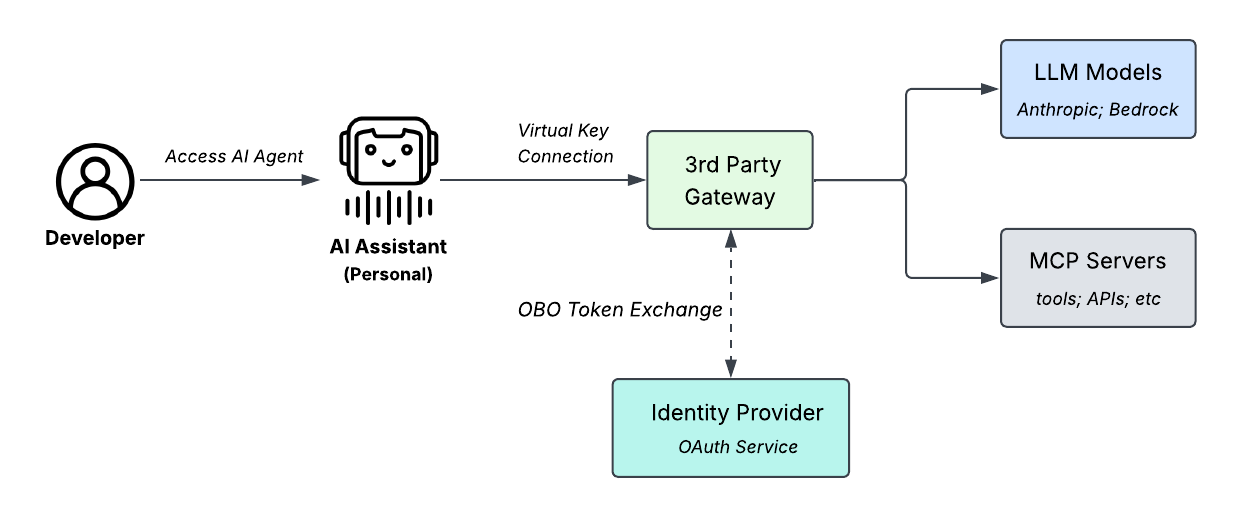 Der nächste Schritt ist ein aufgesetzter IdP.
Dieses Muster ist ein Schritt in die richtige Richtung, da Sie jetzt zumindest wissen, welcher Mensch sich angemeldet hat. Aber letztendlich stoßen Sie auf dasselbe Last-Mile-Problem, nur eine Ebene tiefer: „Welcher Agent hat diese Anfrage initiiert?“ Die Ressource hat keine Möglichkeit zu überprüfen, ob Agent X rechtmäßig im Namen von Benutzer:in Y handelt, und verfügt über keinen Not-Aus-Schalter, um ihn zu stoppen. Es gibt keine Human-in-the-Loop-Beteiligung, keine Möglichkeit, diesen spezifischen Agenten zu blockieren, und keine Möglichkeit, seinen Zugriff zu widerrufen. Der Agent ist in diesem Ablauf immer noch kein vollwertiger Teilnehmer; er leiht sich die Identität der Benutzer:in lediglich komplett aus. Wenn Sie einen der „Confused Deputy“-Vorfälle mitbekommen haben, die die Runde gemacht haben, sollte dies eher nach einem Risiko klingen, nicht nach einer Lösung.
Aber wie würde eine Lösung aussehen? Wir haben bereits festgestellt, dass das Hinzufügen eines IdPs auf der Gateway-Ebene Ihnen zwar eine Richtung vorgibt, Sie aber nicht an Ihr Ziel bringt, zu wissen, welche:r Benutzer:in welchen Agenten aufgefordert hat, welche Aktion auszuführen.
Was ist die Lösung für agentenbasierte Identity Governance?
Die Antwort liegt darin, KI-Agenten als vollwertige Identitäten innerhalb Ihres Identitäts- und Zugriffsmanagement-Frameworks zu behandeln und die Autorisierungsprüfungen für Benutzer und Agenten auf Anfrageebene und nicht auf Ressourcenebene zu verknüpfen. Bei Okta stellen wir diese Funktion mit Okta for AI Agents bereit, wie in der folgenden Abbildung dargestellt.
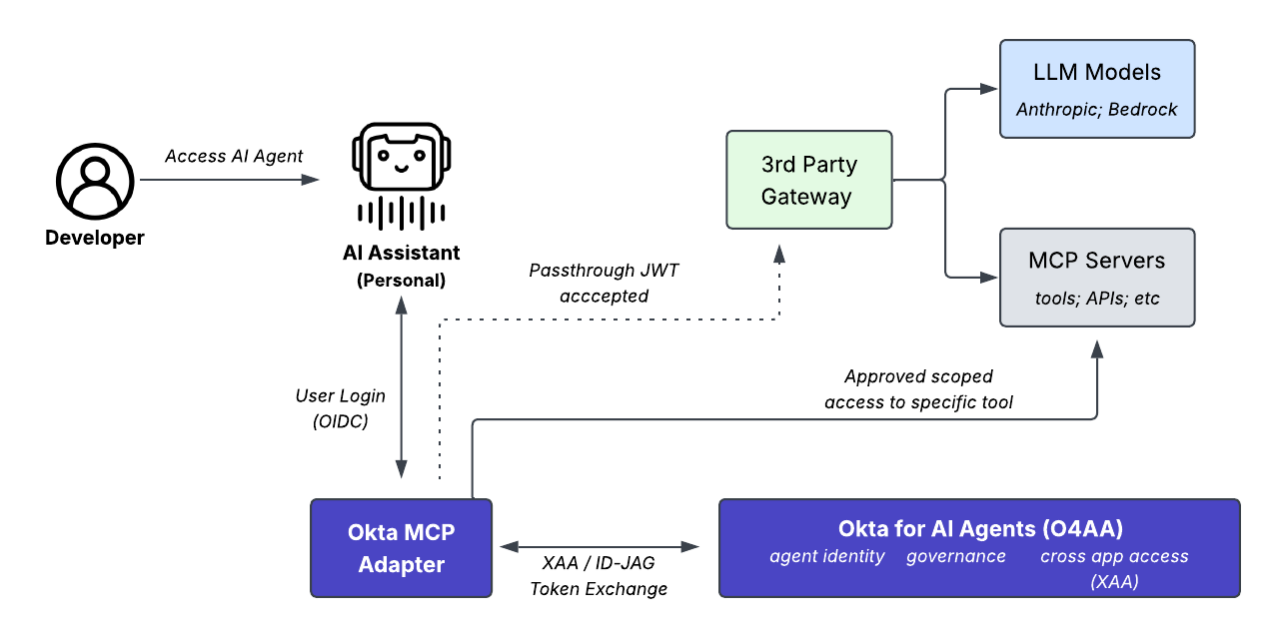 Die Lösung: Der Assistent erhält eine eigene verwaltete Identität. Der Mensch meldet sich einmal an; der Adapter führt einen Token-Austausch an der Identity-Ebene durch; nur ein genehmigtes, zweckgebundenes Token erreicht jemals das eigentliche Tool.
Mit diesem Setup können sich Benutzer:innen vor einer Anfrage authentifizieren und vor allem ihre Berechtigungen auf Benutzerebene (die eine Obergrenze für das festlegen, worauf sie zugreifen können) mit jeder Anfrage verknüpfen, die sie über diesen Agenten stellen. Benutzer:innen können natürlich unterhalb der Obergrenze agieren, aber sie können diese niemals überschreiten. Mit diesem Modell, das durch die Cross App Access-Spezifikation bereitgestellt wird, können wir endlich die Probleme auf der letzten Meile überwinden, auf die wir bei der Bereitstellung und Operationalisierung von KI-Agenten stoßen.
Wie dynamische Autorisierung auf Request-Ebene funktioniert
Authentifizierung: Der/die menschliche Benutzer:in authentifiziert sich über OpenID Connect (OIDC).
Berechtigungs-Scoping: Die Identity-Ebene prüft drei verschiedene Richtlinien, bevor sie ein Token ausstellt:
Agentenautorisierung: Ist dieser Agent berechtigt, im Namen dieser Benutzer:in zu handeln?
Zielerreichbarkeit: Ist dieser Agent autorisiert, auf diese bestimmte Ressource zuzugreifen?
Obergrenze für Benutzerberechtigungen: Was genau darf diese:r Benutzer:in mit dieser Ressource tun (lesen/schreiben/berühren)?
Token-Ausstellung: Das System generiert ein kurzlebiges, einmalig verwendbares gebundenes Bearer Token, das die explizite Schnittmenge der Berechtigungen von Agent und Mensch enthält.
Die Überschneidung findet nicht an einem einzigen Ort statt. Wie die folgende Abbildung zeigt, werten zwei Autorisierungspunkte die tatsächliche Richtlinie darüber aus, worauf Mensch und Agent zugreifen können. Der erste Tool-Aufruf des KI-Agenten erreicht den Okta MCP Bridge Adapter, der für einige Interaktionen zuständig ist. Zunächst vermittelt es die menschliche Anmeldung über ein Standard-OpenID-Connect-Muster (OIDC). Dann orchestriert es den Cross-App-Access-Handshake zwischen dem Autorisierungsserver der Okta-Org (der die Berechtigungen des Agenten auswertet und das ID-JAG-Token ausstellt) und dem Autorisierungsserver der Ressource, um ein gebundenes Bearer Token auszustellen (das sowohl die Berechtigungen des Agenten ALS AUCH die des Menschen enthält). Nur das Token, das das Ergebnis der Prüfungen durch Mensch und Agent enthält, erreicht den MCP-Server.
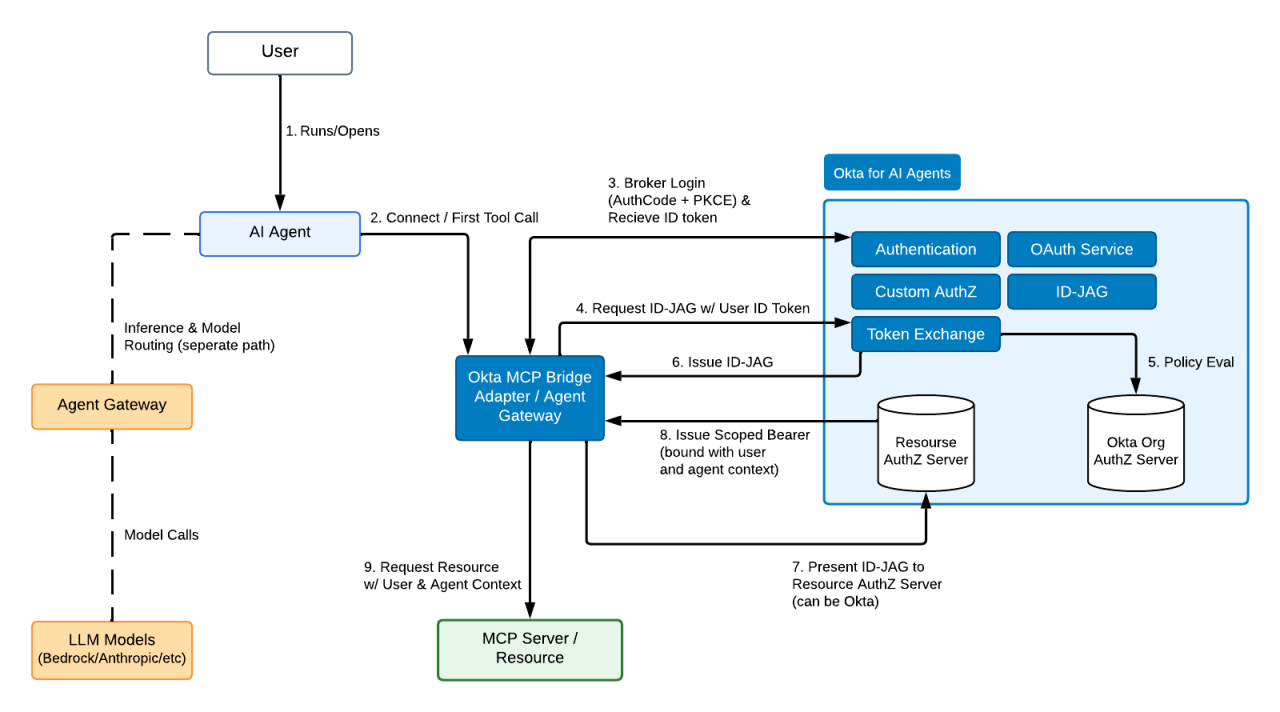 Die Funktionsweise von Cross App Access über Okta for AI Agents. Der Mensch authentifiziert sich einmalig; der Agent fordert eine kurzlebige, einmalig verwendbare Assertion an, die an diesen Menschen gebunden ist; separate Autorisierungsserver prüfen diese anhand der Richtlinie, bevor sie ein bereichsbezogenes Bearer Token ausstellen, dem die Ressource tatsächlich vertrauen kann.
Die Identity-Ebene berechnet diese Schnittmenge, bevor die Anfrage überhaupt die Ressource erreicht, und gibt ein Token zurück, das bereits die Entscheidung enthält. In der Praxis bedeutet das, dass wir drei Fragen stellen müssen: Erstens: Darf dieser Agent im Namen dieses/dieser Benutzer:in handeln? Zweitens: Darf dieser Agent auf diese Ressource zugreifen? Schließlich: Was kann es tatsächlich tun, sobald es die Ressource erreicht hat – einen Datensatz lesen, alle lesen oder in sie schreiben?
In diesem Modell stellen die zwei separaten Autorisierungsserver diese Fragen. Der Autorisierungsserver der Okta Org beantwortet die Frage des Agenten: „Darf dieser Agent im Namen dieses Benutzers handeln und überhaupt auf diese Ressource zugreifen?“ Der eigene Autorisierungsserver der Ressource (bei dem es sich um Okta oder den ressourceneigenen handeln kann) beantwortet die menschliche Frage: „Ausgehend davon, wer diese Person tatsächlich ist, wozu ist sie zum jetzigen Zeitpunkt berechtigt?“ Keine der beiden Prüfungen allein ist die Schnittmenge; die Schnittmenge ist das bereichsbezogene Bearer Token, das am Ende aus beiden hervorgeht. Die Ressource muss diese Prüfungen nicht für jeden Tool-Aufruf neu implementieren. Es validiert lediglich ein Token und prüft einen Scope.
KI-Gateway vs. verwaltete Agentenidentität: Funktionsvergleich
| Sicherheit und operative Leistungsfähigkeit | Eigenständiges KI-Gateway | KI-Gateway + verwaltete Agentenidentität |
|---|---|---|
| Modell-Routing, Kostenkontrolle und Ratenbegrenzungen | Ja, seine Kernkompetenz | Ja, unverändert |
| Tool- und Datenquellen-Scoping | Pro Schlüssel oder pro Team, kein Benutzerkontext | Pro Benutzer:in, zentral verwaltet |
| Vollwertige, verwaltete Agentenidentität | Nein, Identität ist ein statischer Schlüssel | Ja, eine registrierte, eigene Identität |
| Verifizierbare Delegierung (Agent, der für eine:n bestimmte:n Benutzer:in handelt) | Nein, die Anfrage hat einen Schlüssel, keinen Akteur | Ja, jeder Aufruf enthält die Person, die ihn autorisiert hat |
| Lebenszyklus von Anmeldeinformationen | Langlebige gemeinsam genutzte Schlüssel | Kurzlebige, agentenspezifische Tokens |
| Standard-Zugriffsstatus | Standardmäßig offen, bis jemand etwas anderes konfiguriert | Standardmäßig verweigern (Least Privilege) |
| Governance des Agenten-Lebenszyklus | DIY | Verwaltet wie jede andere Identität |
Obwohl das Gateway ein starkes Eingangstor für Kosten und Routing darstellt, lässt sich nicht leugnen, dass es (Wortspiel durchaus beabsichtigt) eine Identitätskrise hat. Die Entscheidung darüber, wer was sehen darf, gehört eine Ebene tiefer und muss mit der Anfrage bis zur Ressource weitergegeben werden, ohne am Gateway zu enden.
Praxisbeispiel: Durchsetzung von Berechtigungsobergrenzen
Stellen Sie sich vor, Sie haben einen internen Bot, der Gehaltsinformationen abrufen kann. Drei verschiedene Personen sprechen mit demselben Bot: Charlie, ein:e reguläre:r Mitarbeiter:in, die oder der nur das eigene Gehalt sehen sollte; jemand aus der Compliance-Abteilung, der die Gehälter aller sehen (aber nicht ändern) darf; und ein CFO, der die Gehälter aller sehen und aktualisieren kann. Derselbe Bot, dieselbe Aktion (in gewisser Weise), aber unterschiedliche Personen mit unterschiedlichen Obergrenzen.
Charlie fragt den Bot über das Gateway: „Wie hoch ist mein Gehalt?“ Der Bot liefert die korrekte Antwort, nehmen wir an, 70.000 $. Das Problem ergibt sich aus der Folgefrage. Charlie gibt „Wie hoch ist das Gehalt von Alice?“ ein, und der Bot liefert erneut die Antwort.
An keiner Stelle zwischen der/dem Benutzer:in, dem Agenten, dem KI-Gateway oder dem MCP-Server wurde jemals der Unterschied zwischen „als Charlie“ und „als jede Person, die diesen Schlüssel besitzt“, überprüft. Das Gateway funktionierte genau so, wie das Plattform-Team es konfiguriert hatte; es wurde nur nie dafür konfiguriert, zwischen ihnen zu unterscheiden, weil es den Unterschied nicht erkennen kann.
Lassen Sie uns nun eine Identity-Ebene unter dasselbe Gateway legen. Charlie authentifiziert sich als er selbst. Jeder Aufruf ist nun die Schnittmenge aus drei Dingen: was der Agent anfordern kann, wozu Charlie persönlich berechtigt ist und was die Zugriffsrichtlinie der Ressource zulässt.
Wenn Charlie sein eigenes Gehalt abfragt, sind alle drei Anforderungen erfüllt. Wenn er Alices anfordert, lehnt das System seine Anfrage ab, da der mittlere Term in dieser Schnittmenge fehlschlägt, selbst wenn der Agent oder das Gateway es andernfalls zulassen würden. Wenn wir die Persona auf den CFO ändern und denselben Agenten verwenden, lässt das System die Anfrage zu, da der CFO eine andere Berechtigungsobergrenze hat. Die Berechtigungsobergrenze ist an die Person gebunden und nicht an einen Schlüssel, den jede:r im Team verwenden könnte, um dieselbe Frage zu stellen.
Häufig gestellte Fragen
Jedes Mal wird mir eine Variante der Frage „Übernimmt unser Gateway das nicht bereits?“ gestellt.
Denken Sie daran: Ein Schlüssel identifiziert eine Aufruferkategorie, keinen Aufrufer. Es beinhaltet keine aktive, personengebundene Berechtigung, die Sie an der Ressource überprüfen oder in dem Moment widerrufen können, in dem jemand die Rolle wechselt. Zwei Personen, die sich einen Schlüssel teilen, sehen für alles Nachgelagerte identisch aus.
Der gesamte Informationsaustausch findet im Backend statt. Entwickler:innen kommunizieren weiterhin genauso mit ihrem Coding-Assistenten wie gestern; die Authentifizierung und der Token-Austausch finden im Hintergrund statt und nicht in ihrem Workflow. Wenn es die tägliche Arbeitsweise von Entwickler:innen verändert, wurde es falsch entwickelt.
Ich rate davon ab. Faktisch schaffen Sie so für immer eine DIY-Governance für jedes einzelne Tool durch das Team, das zufällig für das jeweilige Tool zuständig ist. Es bietet Ihnen keine einzelne, dauerhafte und zentral verwaltete Identität, die einem Audit unterzogen oder widerrufen werden kann. Stattdessen erhalten Sie mehrere leicht unterschiedliche, manuell erstellte Versionen derselben Prüfung und keine gemeinsame Informationsquelle dafür.
Sollten Sie Ihr KI-Gateway durch eine Identity-Ebene ersetzen?
Das Argument hier lautet nicht „Entfernen Sie Ihr Gateway.“ Ein Agent-Gateway hat seinen Platz in der IT-Landschaft für die Aufgaben, für die es entwickelt wurde, wie Routing, Kostenkontrolle, Ratenbegrenzungen oder Tool-Erkennung. Es wurde nicht dafür konzipiert, spezifischen Benutzerkontext zu übertragen. Das ist eine andere Ebene, die separat angesiedelt ist und jede Anfrage für sich genommen auswertet.
Bedeutet das also, dass alles, was Sie bereits aufgebaut haben, verworfen werden muss? Nein. Das bedeutet, dass das Gateway und die Identity-Ebene zwei unterschiedliche Aufgaben erfüllen und die meisten heutigen Architekturen nur für eine davon bezahlen.
Übernehmen Sie die Kontrolle über Ihre KI-Identitätsarchitektur
Um das Problem der letzten Meile zu lösen, benötigen Sie eine dedizierte Identity-Ebene, die sich neben Ihrem Gateway befindet und jede Anfrage individuell auswertet.
Mit Okta for AI Agents können Sie eine Autorisierungsobergrenze auf Anfrageebene festlegen, die an den menschlichen Benutzer gebunden ist, anstatt sich auf einen statischen, dauerhaften Schlüssel zu verlassen. Okta hilft Ihnen dabei, autonome Funktionen sicher zu skalieren, indem Ihre Belegschaft und Entwickler-Workflows abgesichert werden, ohne Reibungsverluste für Entwickler:innen zu verursachen.
Sind Sie bereit, die Identitätskrise Ihres Gateways zu beenden?
Laden Sie den Blueprint für das sichere agentengesteuerte Unternehmen herunter, um Ihre Agenten-Sicherheitsarchitektur zu bewerten und zu erfahren, wie Okta Ihnen helfen kann, Ihre Unternehmens-KI-Agenten unter Kontrolle zu bringen, indem diese als vollwertige Identitäten behandelt werden.


